


水务 AI 智能体落地真相:90% 项目失败,根源不在算法
导语
水务行业正从"规模扩张"转向"运营盘活"。SCADA 系统沉淀了 5-10 年的数据,却大多沉睡在服务器里;环保督察常态化,合规成本持续上升;核心技术人员流动,经验断层日益严重。
很多企业把 AI 视为破局钥匙,但一个残酷真相是:90% 的 AI 项目不是死在算法不够先进,而是死在"数据治理之后" — 数据接通了,口径统一了,但模型很聪明,业务却根本不敢用。
今天不谈概念,只谈水务 AI 智能体从"能用"到"敢用"再到"离不开"的真实落地路径。
一、认知纠偏:水务 AI 智能体,不是"聊天机器人"升级
在谈落地之前,必须先厘清一个概念:什么是水务场景下的 AI 智能体?
它不是简单地把工艺手册喂给大模型,然后回答"曝气量怎么调"。一个可落地的智能体,需要具备四层能力:
- 感知理解:看懂传感器实时数据,理解运营人员的业务提问;
- 知识检索:调取历史故障案例、工艺规范、设备档案;
- 推理决策:判断异常类型,推荐处置策略;
- 工具调用:直接派工单、查库存、发通知、生成报表。
"小模型做判断,大模型做表达" — 这是在实践中验证的技术路线。小模型负责分析振动、温度、水质等实时数据,做出精准判断(如"某风机轴承 7 天后可能故障");大模型负责将判断结果转化为可执行、可理解的业务语言(如生成检修建议、自动推送工单)。
落地第一原则:先让 AI 能"干活",再让 AI 会"说话"。
二、一个关键误区:为什么"自由群聊式 Agent"一定失败
在做多智能体系统设计时,一个常见的浪漫化想象是:让多个 Agent 自由通信、协作分工,像一群专家在群里讨论问题。
表面上看是"智能协作",实际上在水务运营这种强监管、高安全要求的场景中,这会导致四大致命问题:
- 语义漂移:每个 Agent 对"异常"的理解不同,有的指水质超标,有的指设备故障;
- 责任不清:风机预警到底该谁处理?工艺调整谁签字?无法追溯决策来源;
- 状态混乱:上下文相互污染,A 厂的对话记录干扰 B 厂的推理;
- 决策不可控:无法审计,无法满足国资监管和环保合规的刚性要求。
真正可行的结构是"分层调度 + 强约束通信 + 单一决策链"。
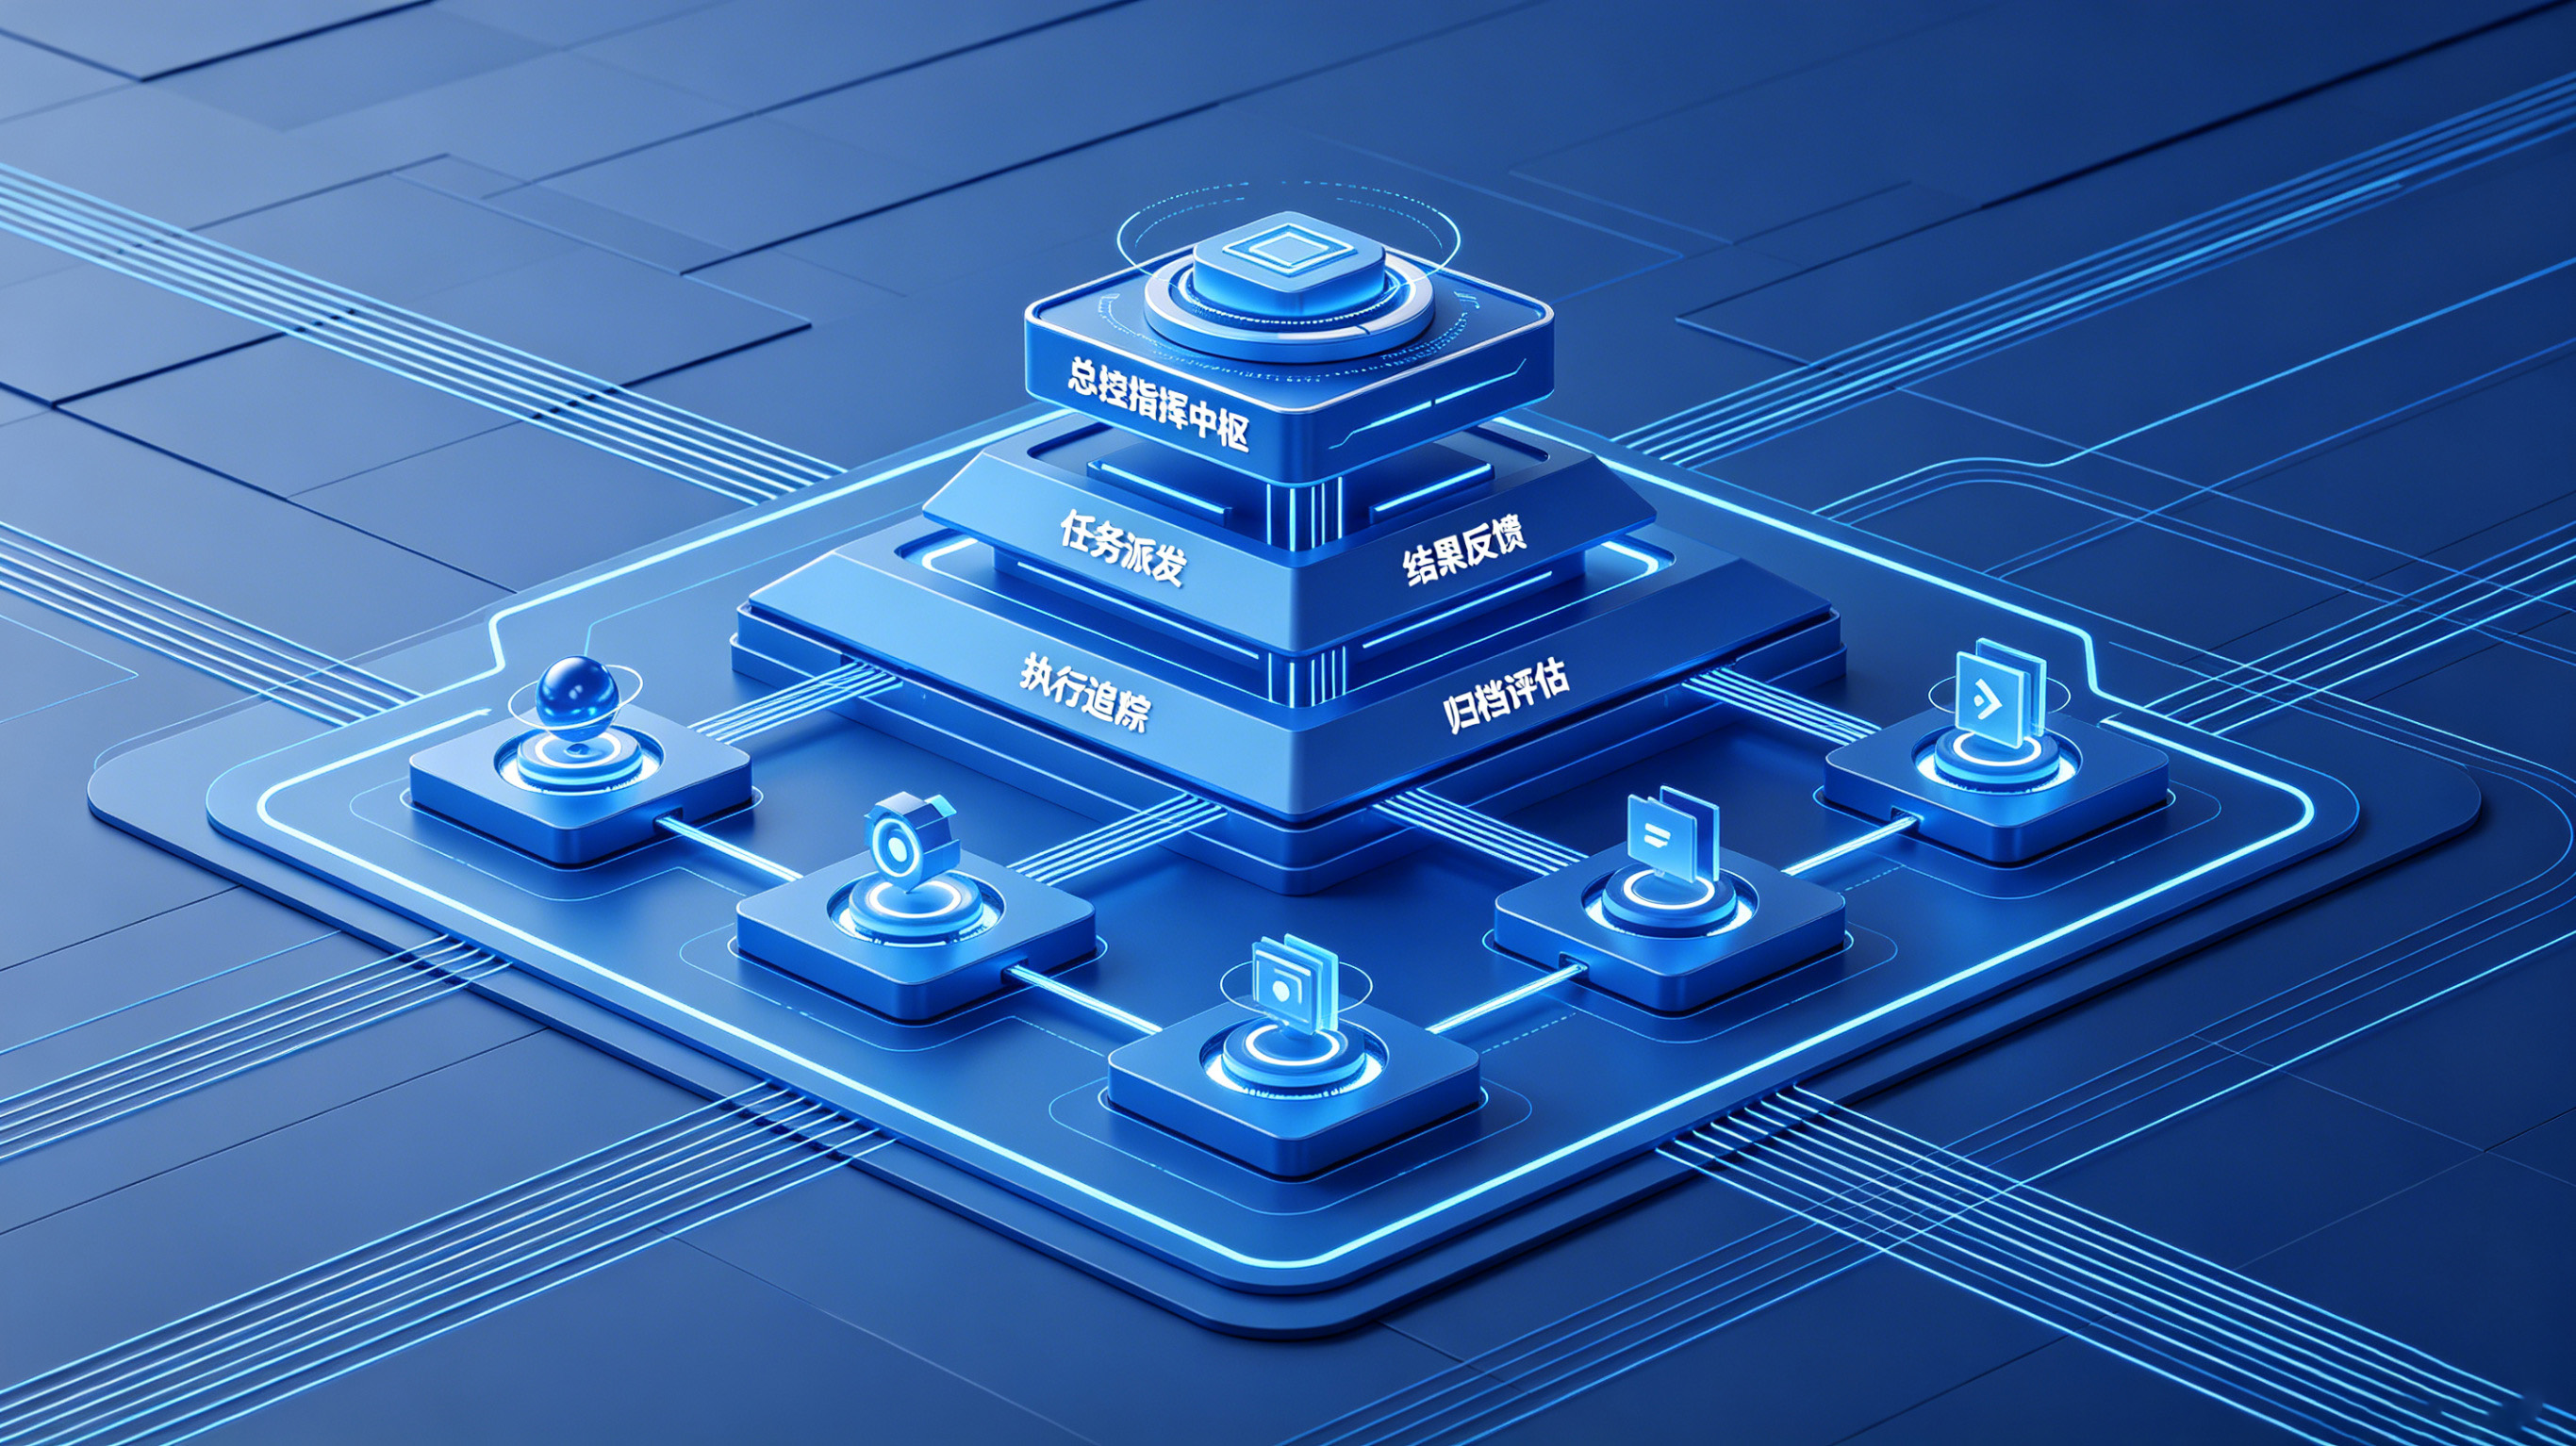
也就是说,不是群聊,而是"指挥体系" — 有明确的任务派发、执行跟踪、结果反馈、归档评估。智能体必须在可控的边界内行动,每一步都可观测、可审计、可回滚。
三、AI 落地的三层演化:从数据治理到监管执行体
企业 AI 落地,不是简单的技术升级,而是系统结构的迁移。结合当前工程实践,可以抽象为三层演化:
第一层:数据治理(Data Governance)
这一阶段解决的是:
- 数据在哪?
- 数据是谁的?
- 数据口径是否一致?
- 是否能被使用?
典型成果是数据中台、主数据管理、指标体系、数据标准化。
但问题是:治理完之后,数据只是"能用",还不能"会用"。
第二层:语义资产层(Semantic Layer)
这是很多企业忽略的一层,也是 AI 成败的分水岭。
你可以理解为:把"表"变成"业务语言"。
例如:
- "进水 COD 表" → 不只是 SQL 里的字段,而是"水质风险语义对象";
- "设备台账" → 不是静态表格,而是关联了维保周期、故障历史、备件库存的"设备健康语义对象";
- "项目成本" → 不是数字堆砌,而是规则 + 上下文推理结构。
这一层的本质,是把数据从"存储对象"升级为"可推理对象"。
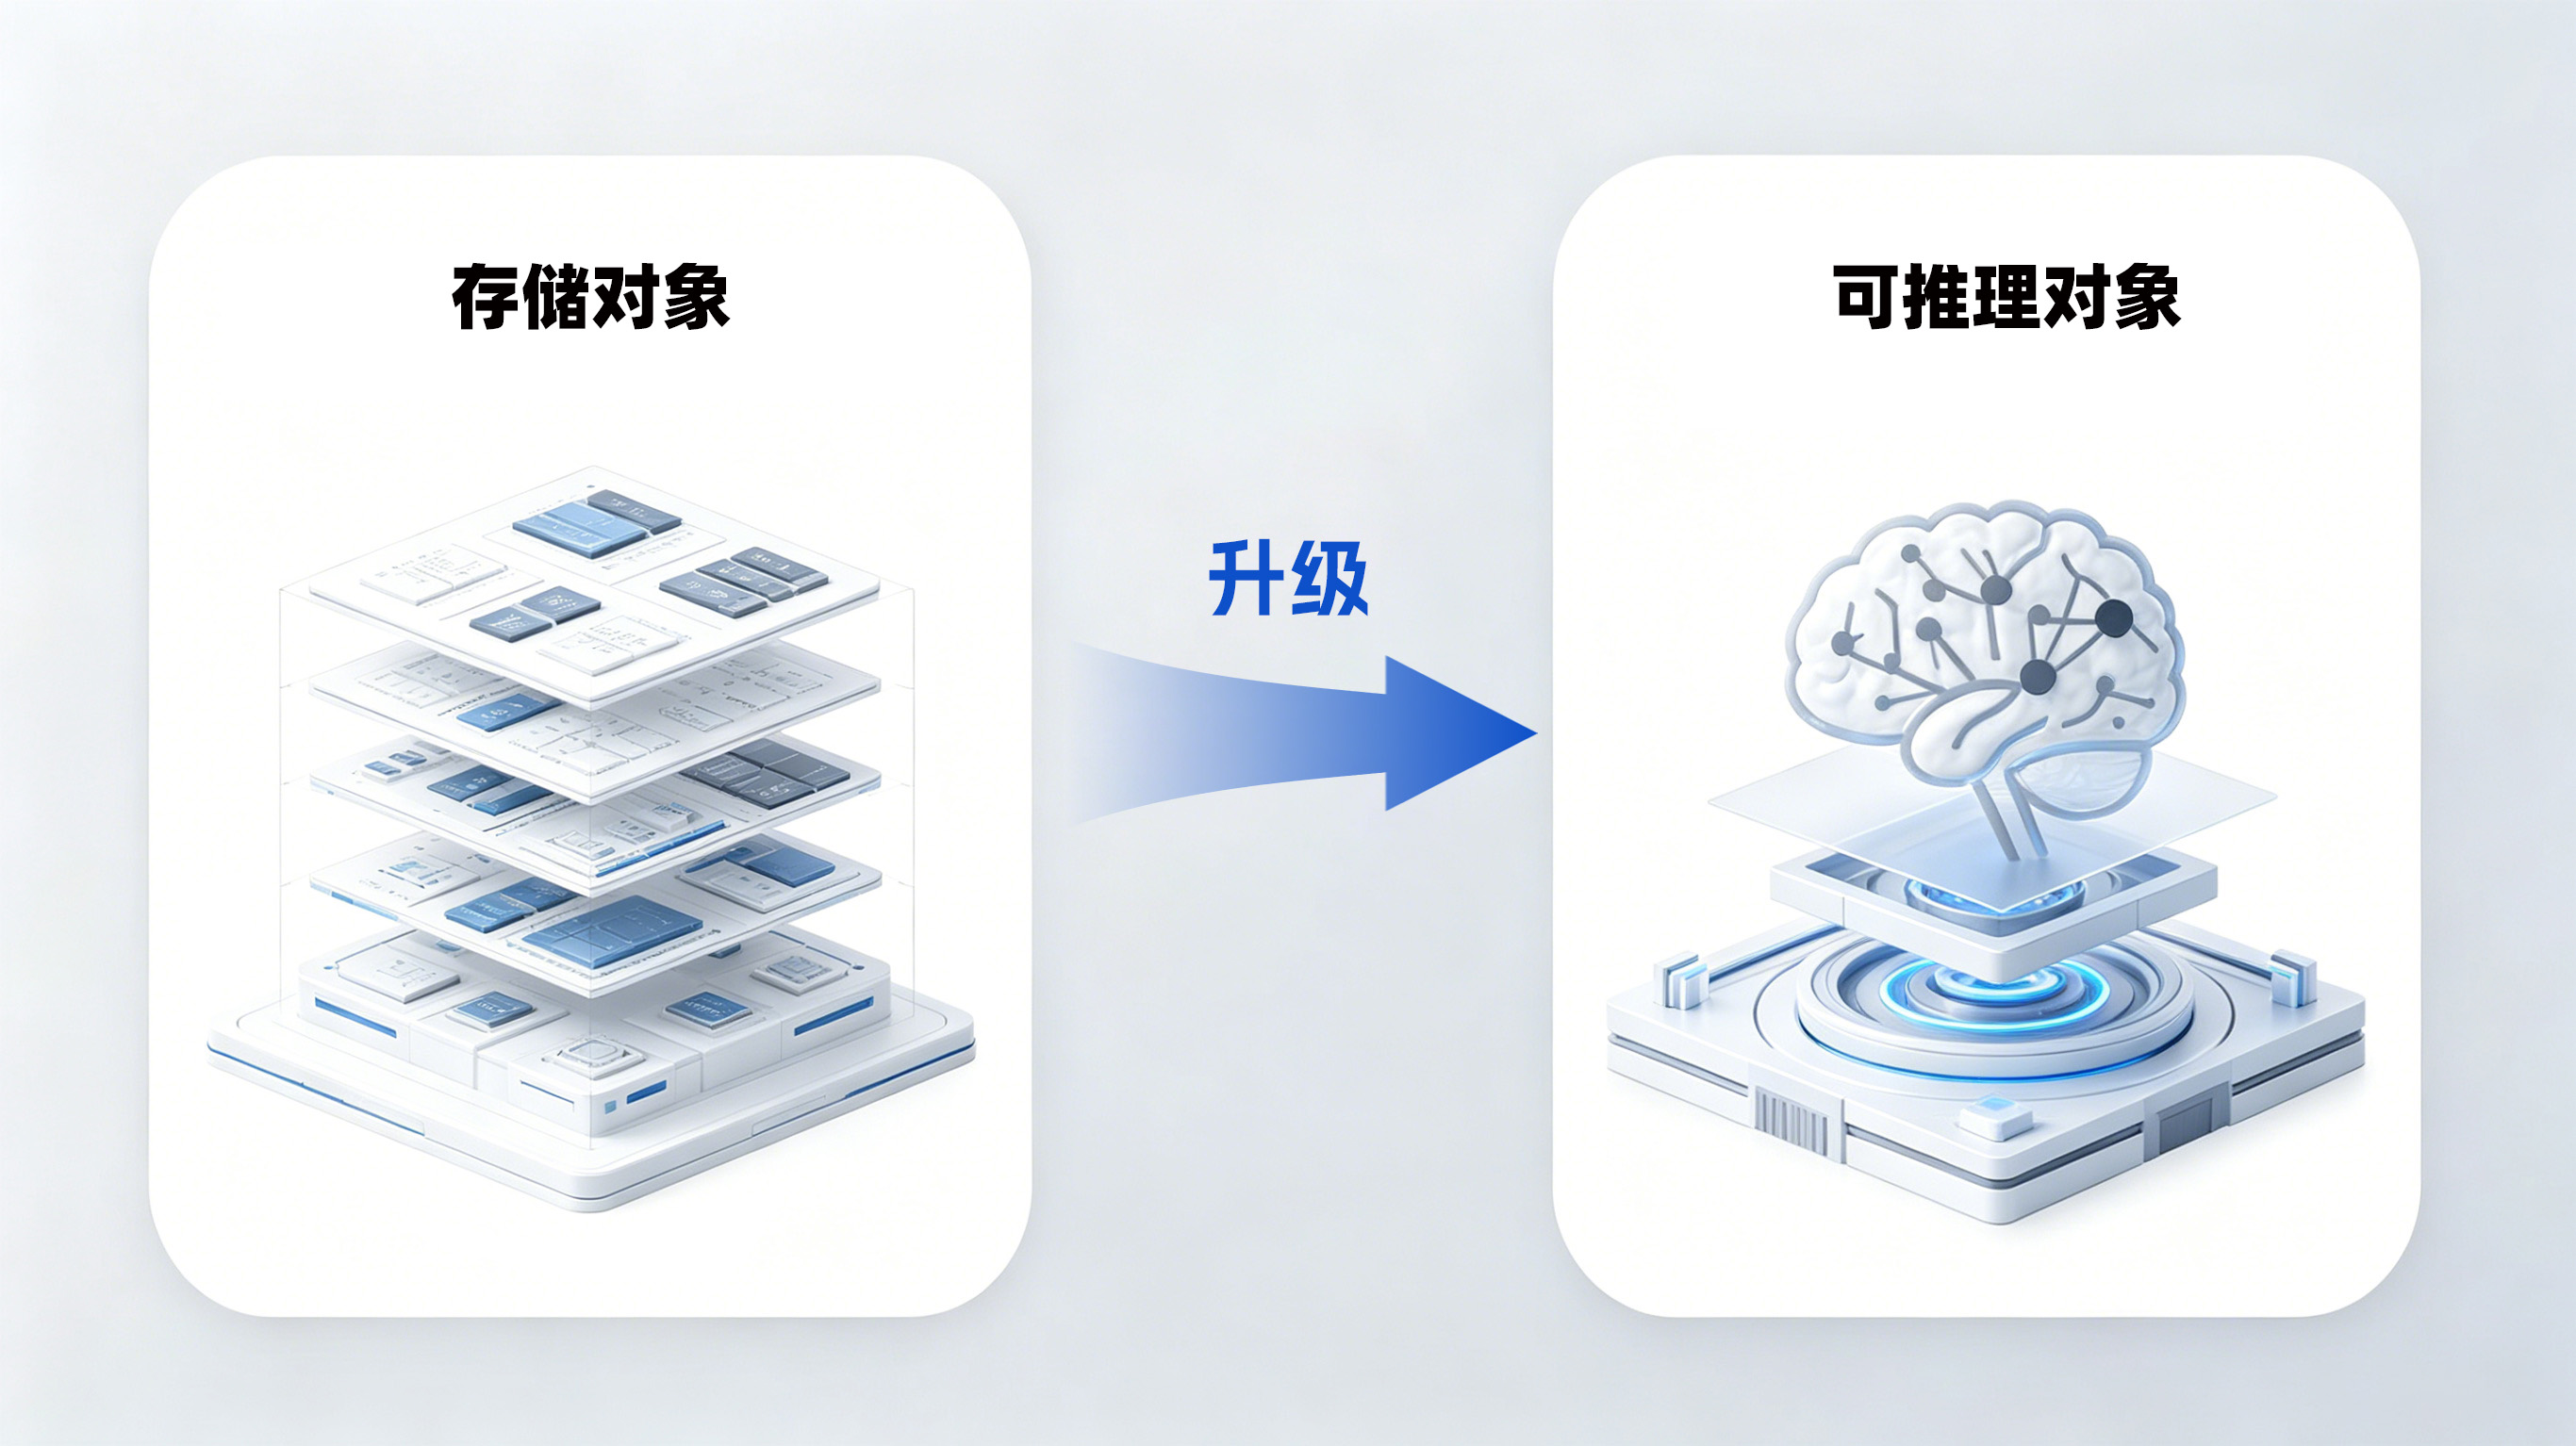
没有语义层,大模型只是在"读表",它知道某个数值是 150,但不知道 150 在这个工艺环节意味着"正常波动"还是"超标预警"。
第三层:监管执行体(Regulatory Agent System)
当语义层成立之后,AI 才开始进入真正的"行动阶段"。
此时智能体不再是:
- 查数据
- 做分析
- 生成报表
而是:
- 自动识别异常行为
- 自动触发穿透分析链路
- 自动生成监管建议
- 自动分发任务到不同业务系统
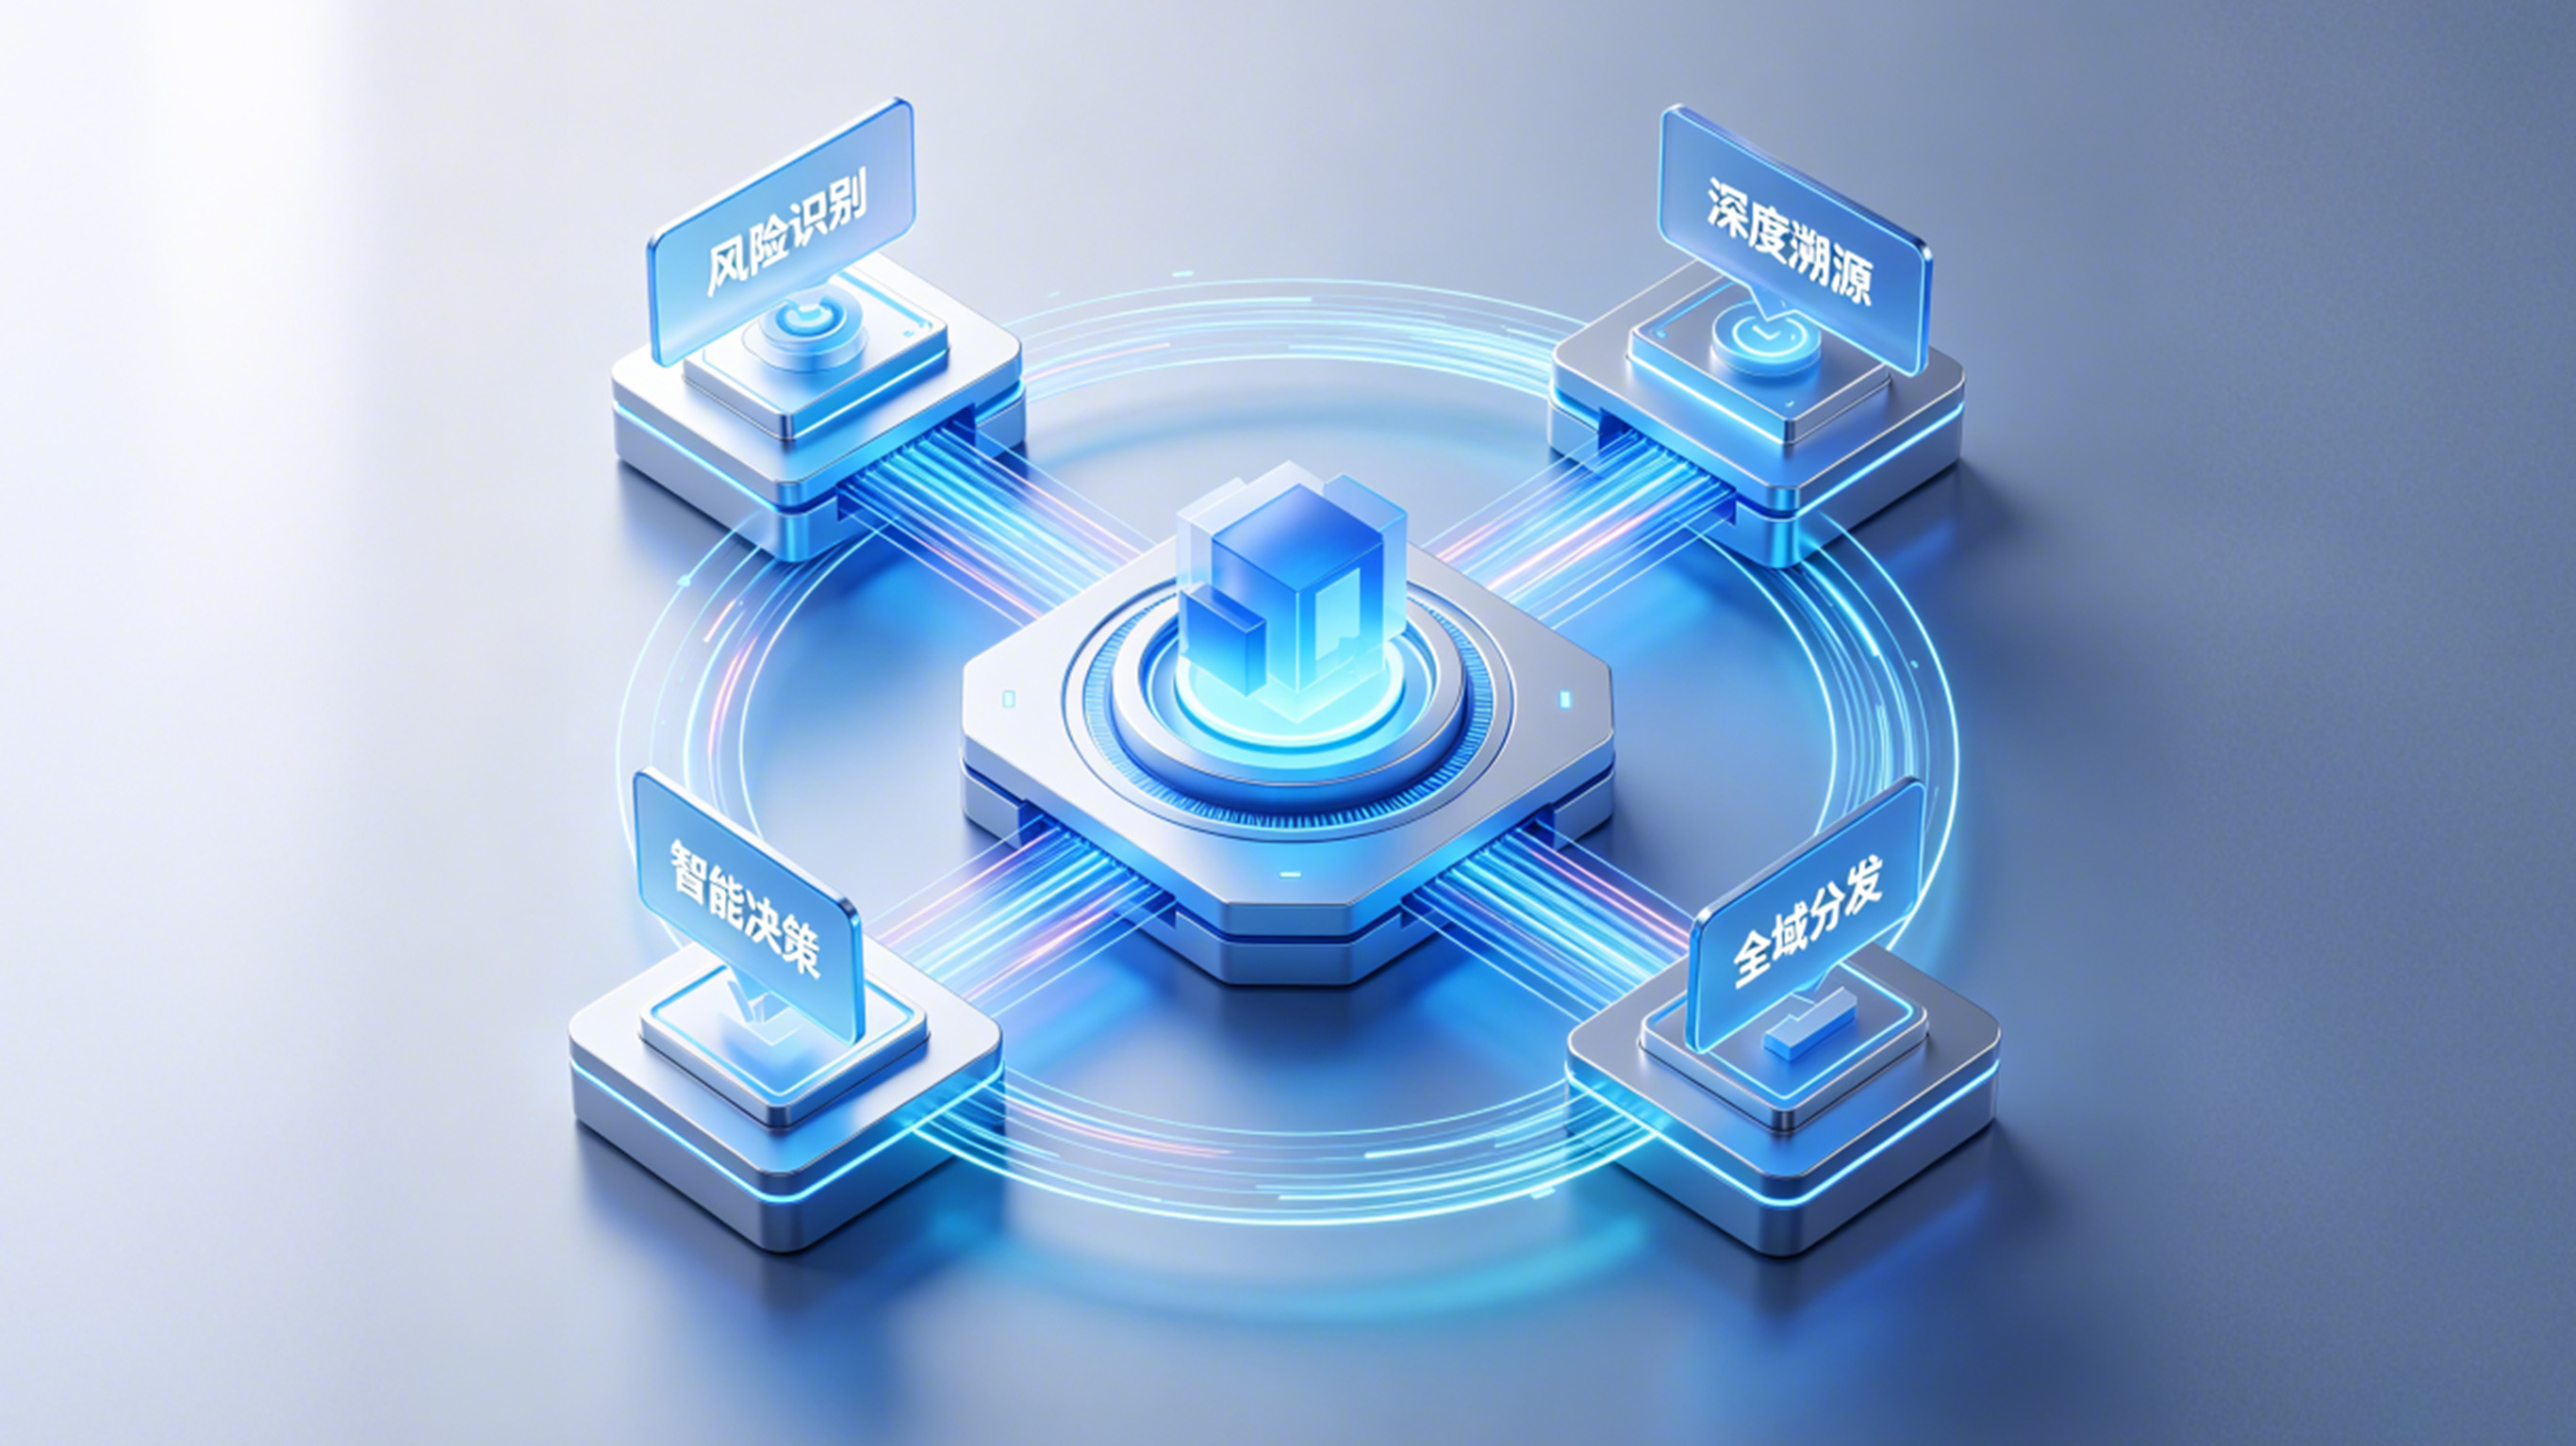
系统结构变成:数据系统 → 语义系统 → 智能体执行系统。
四、策略一:单点突破,从"高频痛点"切入
很多污水厂在规划 AI 时,容易陷入"顶层设计陷阱" — 先画一张覆盖全厂、全工艺、全流程的智能蓝图,再花半年做数据中台,最后发现预算耗尽、士气低落,AI 还是停留在 PPT 里。
最好的路径是"单点突破、快速闭环"。
选择标准有三个:
- 数据基础较好:已有 1-2 年的传感器或业务数据积累;
- 痛点足够痛:当前依赖人工经验、耗时耗力、出错成本高;
- 价值可量化:上线后能在 1-3 个月内看到明确的效率或成本改善。
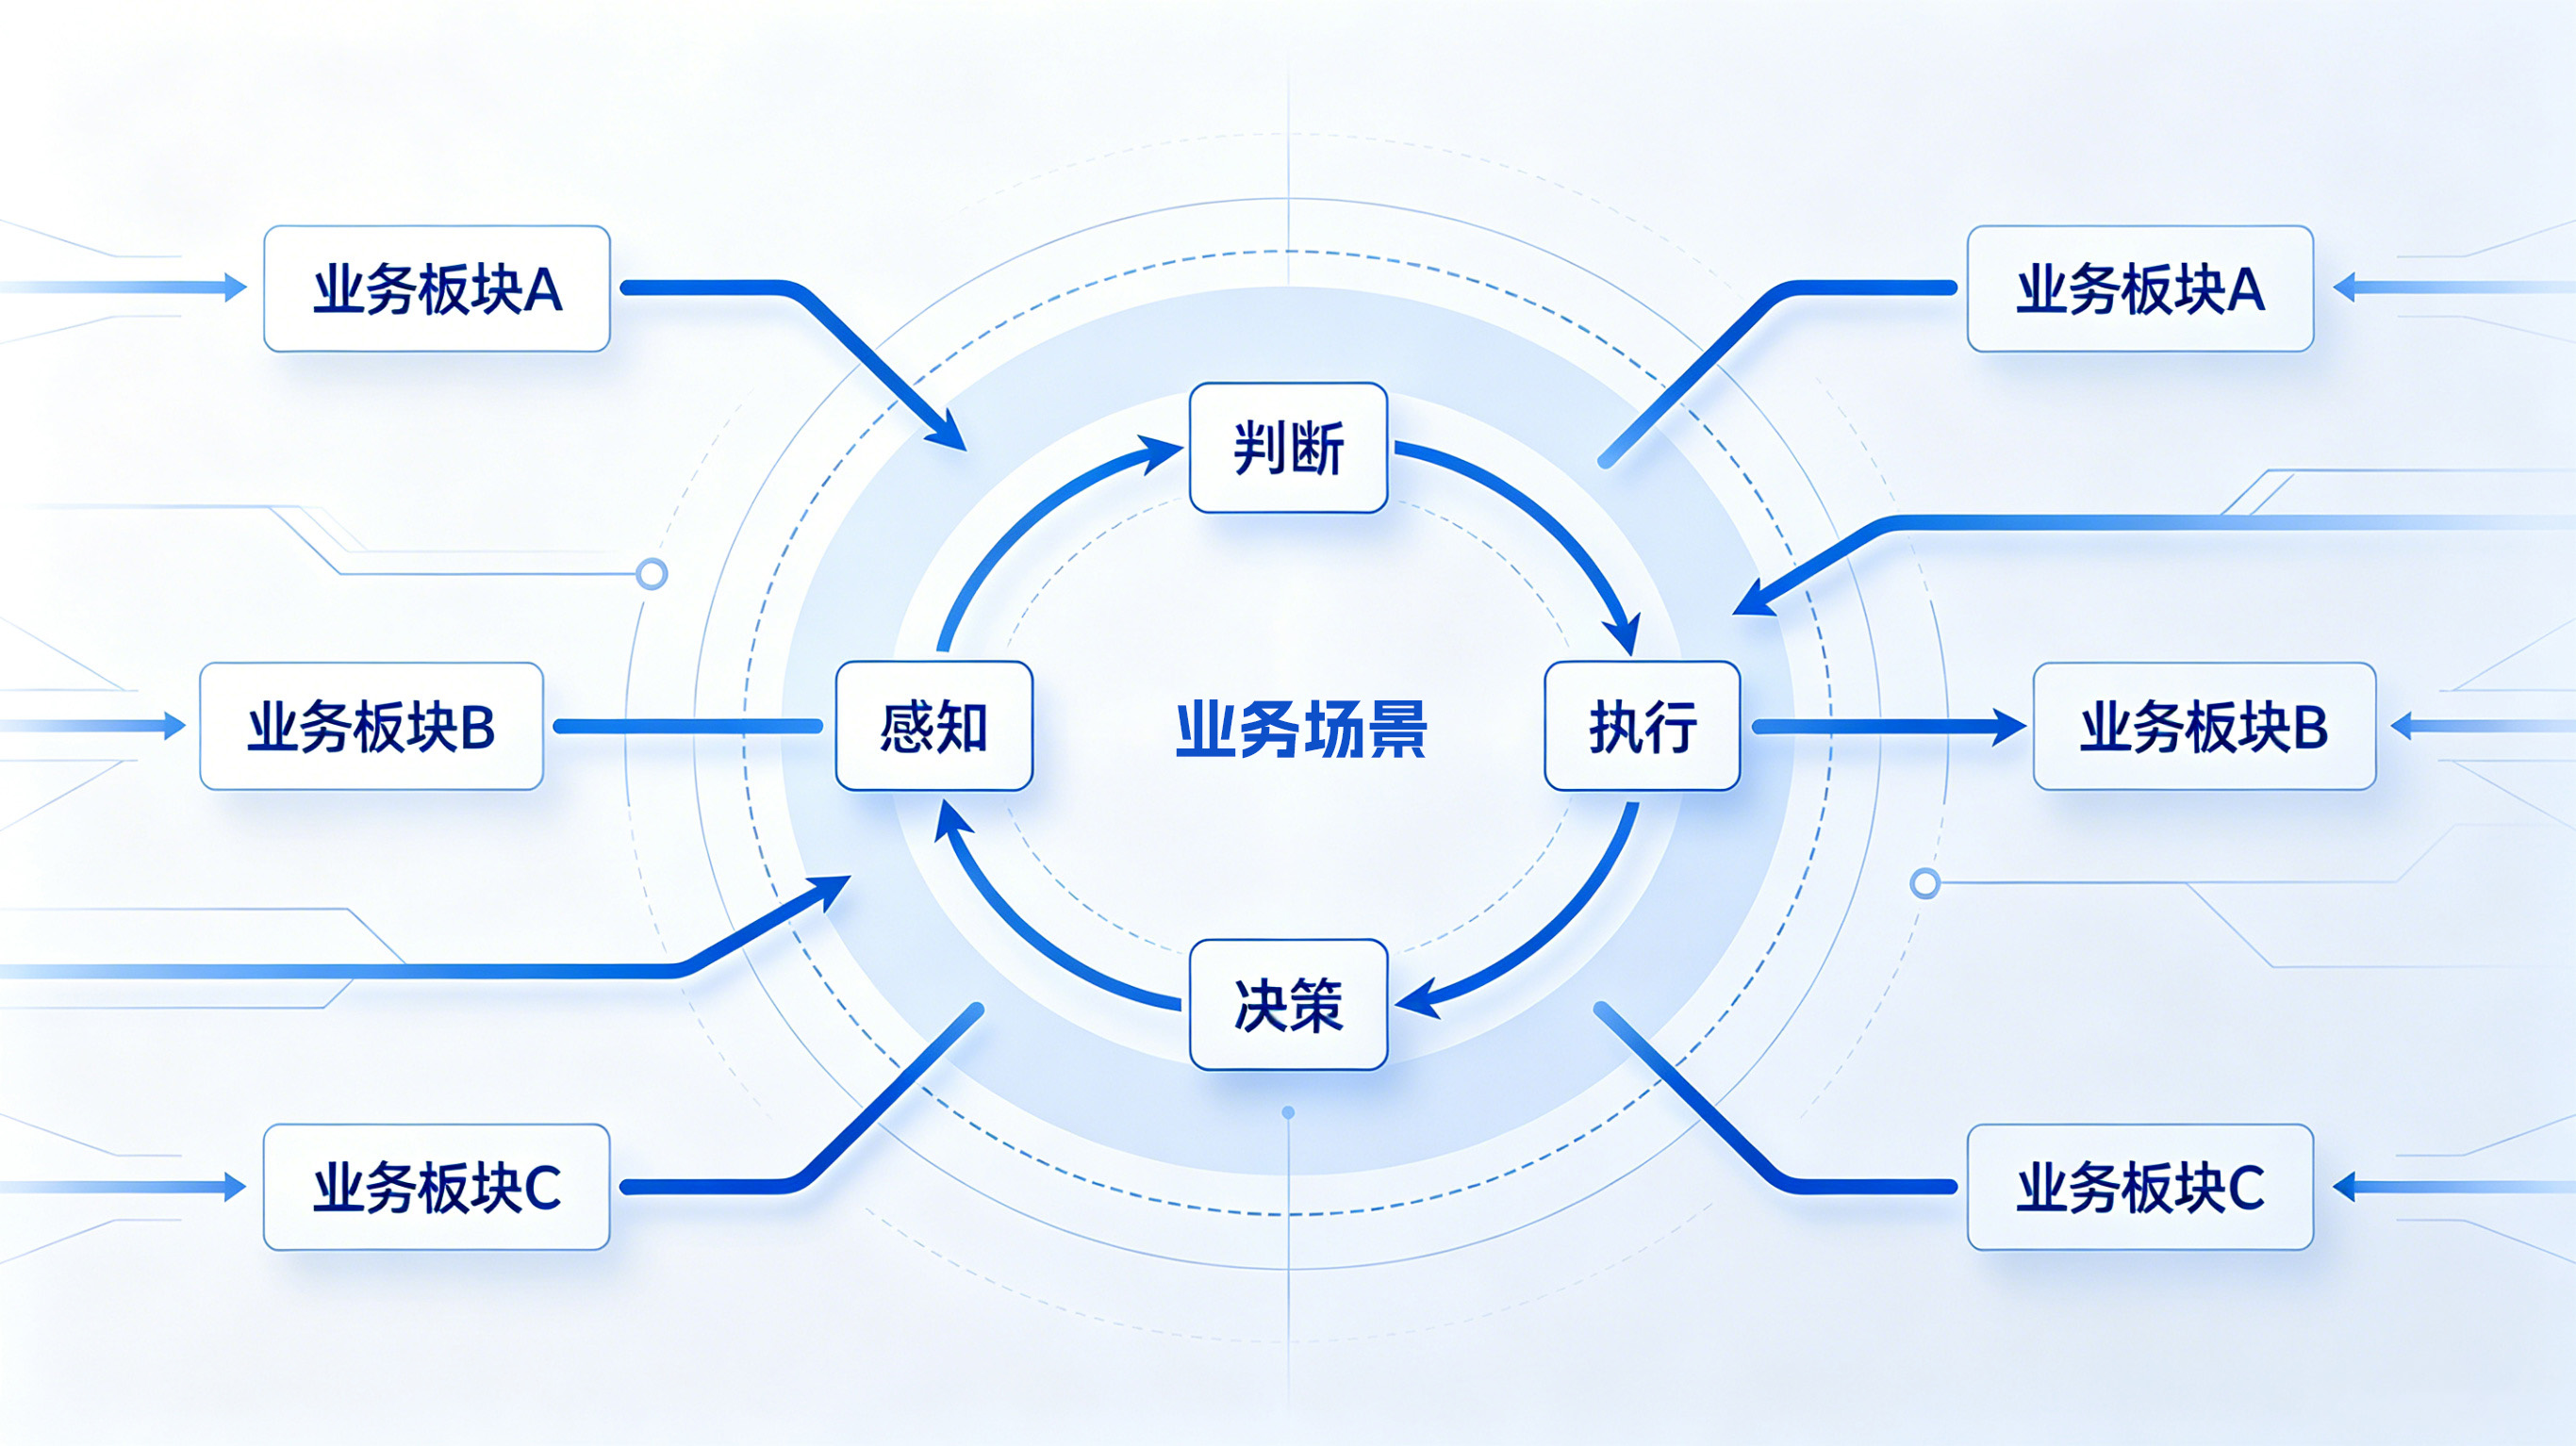
关键动作:让 AI 智能体在一个具体场景里先跑通"感知-判断-决策-执行"的完整闭环,让一线人员尝到甜头,再横向扩展。
五、策略二:数据治理 + 语义层,把"沉睡成本"变成"战略资产"
AI 智能体的上限,往往由数据质量决定。
水务企业的数据困境很典型:多厂多系统数据割裂,生产、财务、采购数据口径不一;SCADA 数据实时但孤立,ERP 数据完整但滞后;纸质台账、Excel 表格、数据库三套体系并行。
没有统一语义层的数据中台,大模型再强也只能"瞎猜"。
真正有效的数据准备,不是简单的"清洗",而是重构:
Step 1:数据结构治理
- 建立主数据模型
- 统一指标体系
- 明确数据责任边界
- 关键词:可治理性
Step 2:语义层抽象(关键跃迁)
- 表 → 业务对象
- SQL → 语义关系
- 指标 → 规则表达
- 关键词:可理解性
Step 3:知识与规则融合
- 工艺规则、环保政策、设备维保规范
- 形成"可执行知识体系"
- 关键词:可推理性
只有完成这三步,历史数据才能真正从"沉睡成本"转化为可检索、可分析、可预测的战略资产。
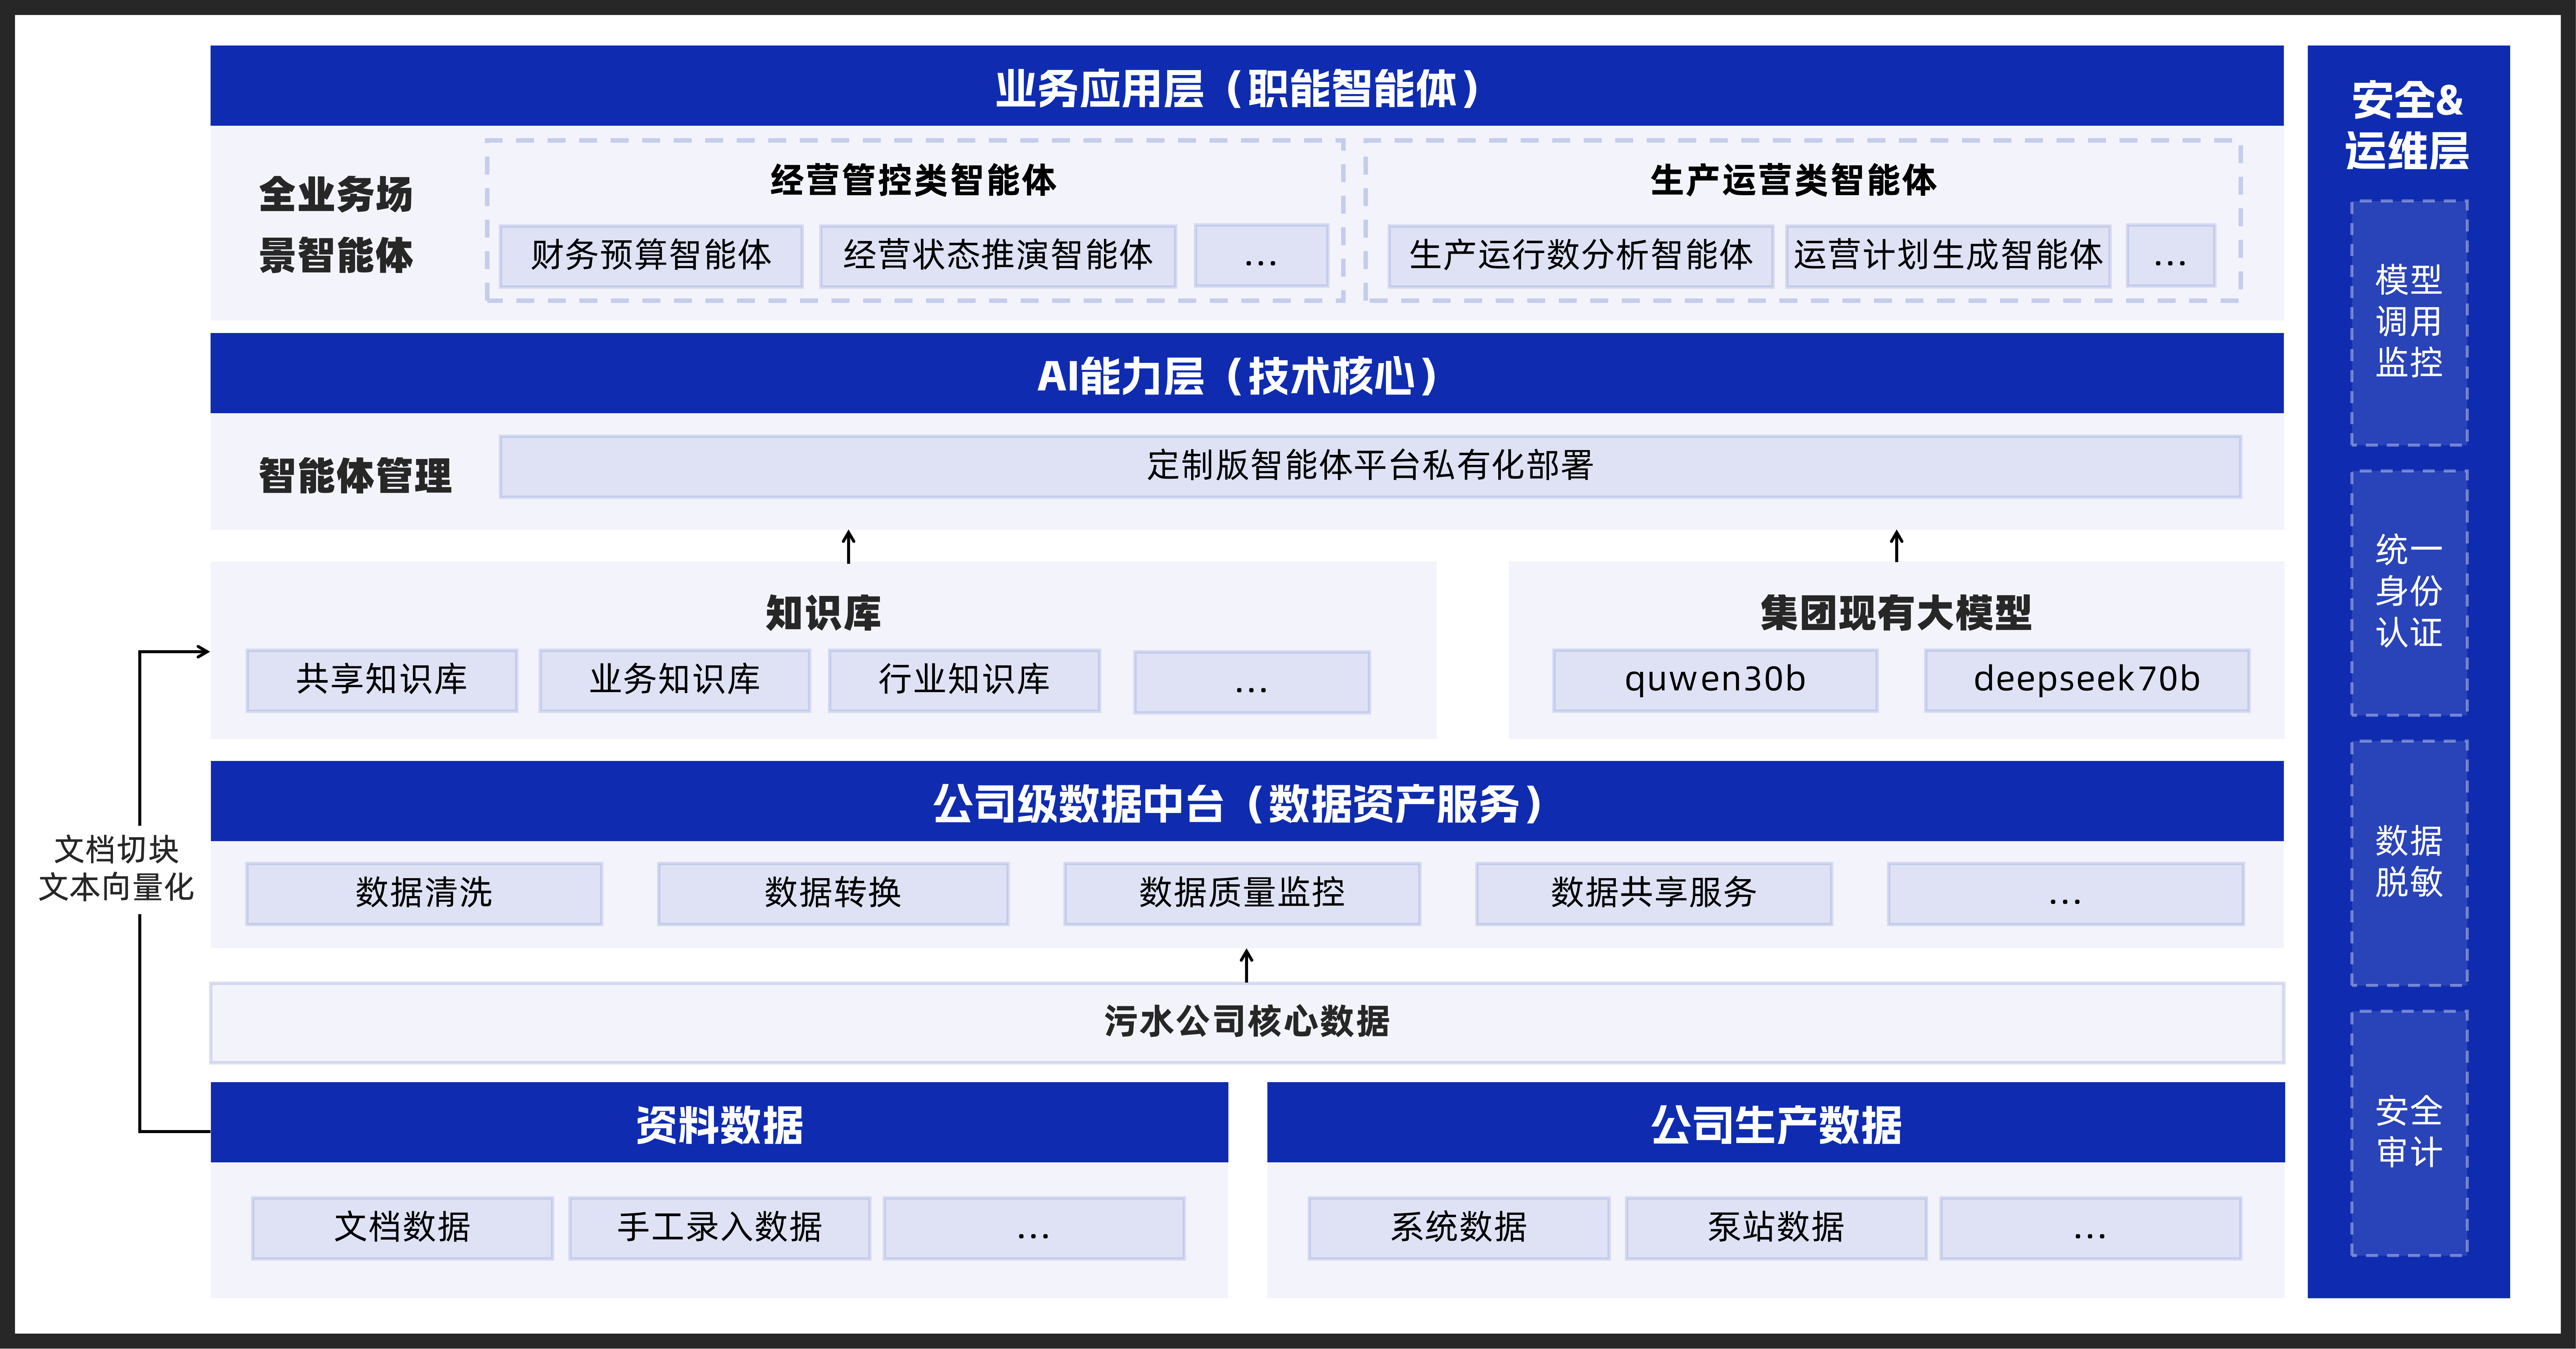
落地第二原则:AI 智能体落地前,先花 30% 的精力做数据治理与语义层构建,否则 70% 的 AI 预算会浪费在"让模型猜数据含义"上。
六、策略三:智能体编排与监管闭环,让 AI 从"顾问"变成"执行体"
当数据基础和语义层就绪后,核心挑战变成:如何让多个智能体有序协作,而不是无序群聊?
这需要智能体编排(Agent Orchestration)能力:
- 任务拆解:把"本月经营分析"拆成数据采集、异常识别、根因分析、报告生成、领导签批等子任务;
- 工具调用:让智能体能够查询数据库、调用计算模型、推送工单、发送通知;
- 状态管理:确保每个任务的上下文独立、清晰、不污染;
- 审计追踪:每一步操作留痕,满足国资监管和环保督查的合规要求。
最终,系统要形成监管闭环:
- 自动发现异常
- 自动生成解释链(为什么判断这是异常?依据哪条规则?)
- 自动推送任务到责任人和业务系统
- 自动跟踪执行结果,形成闭环报告
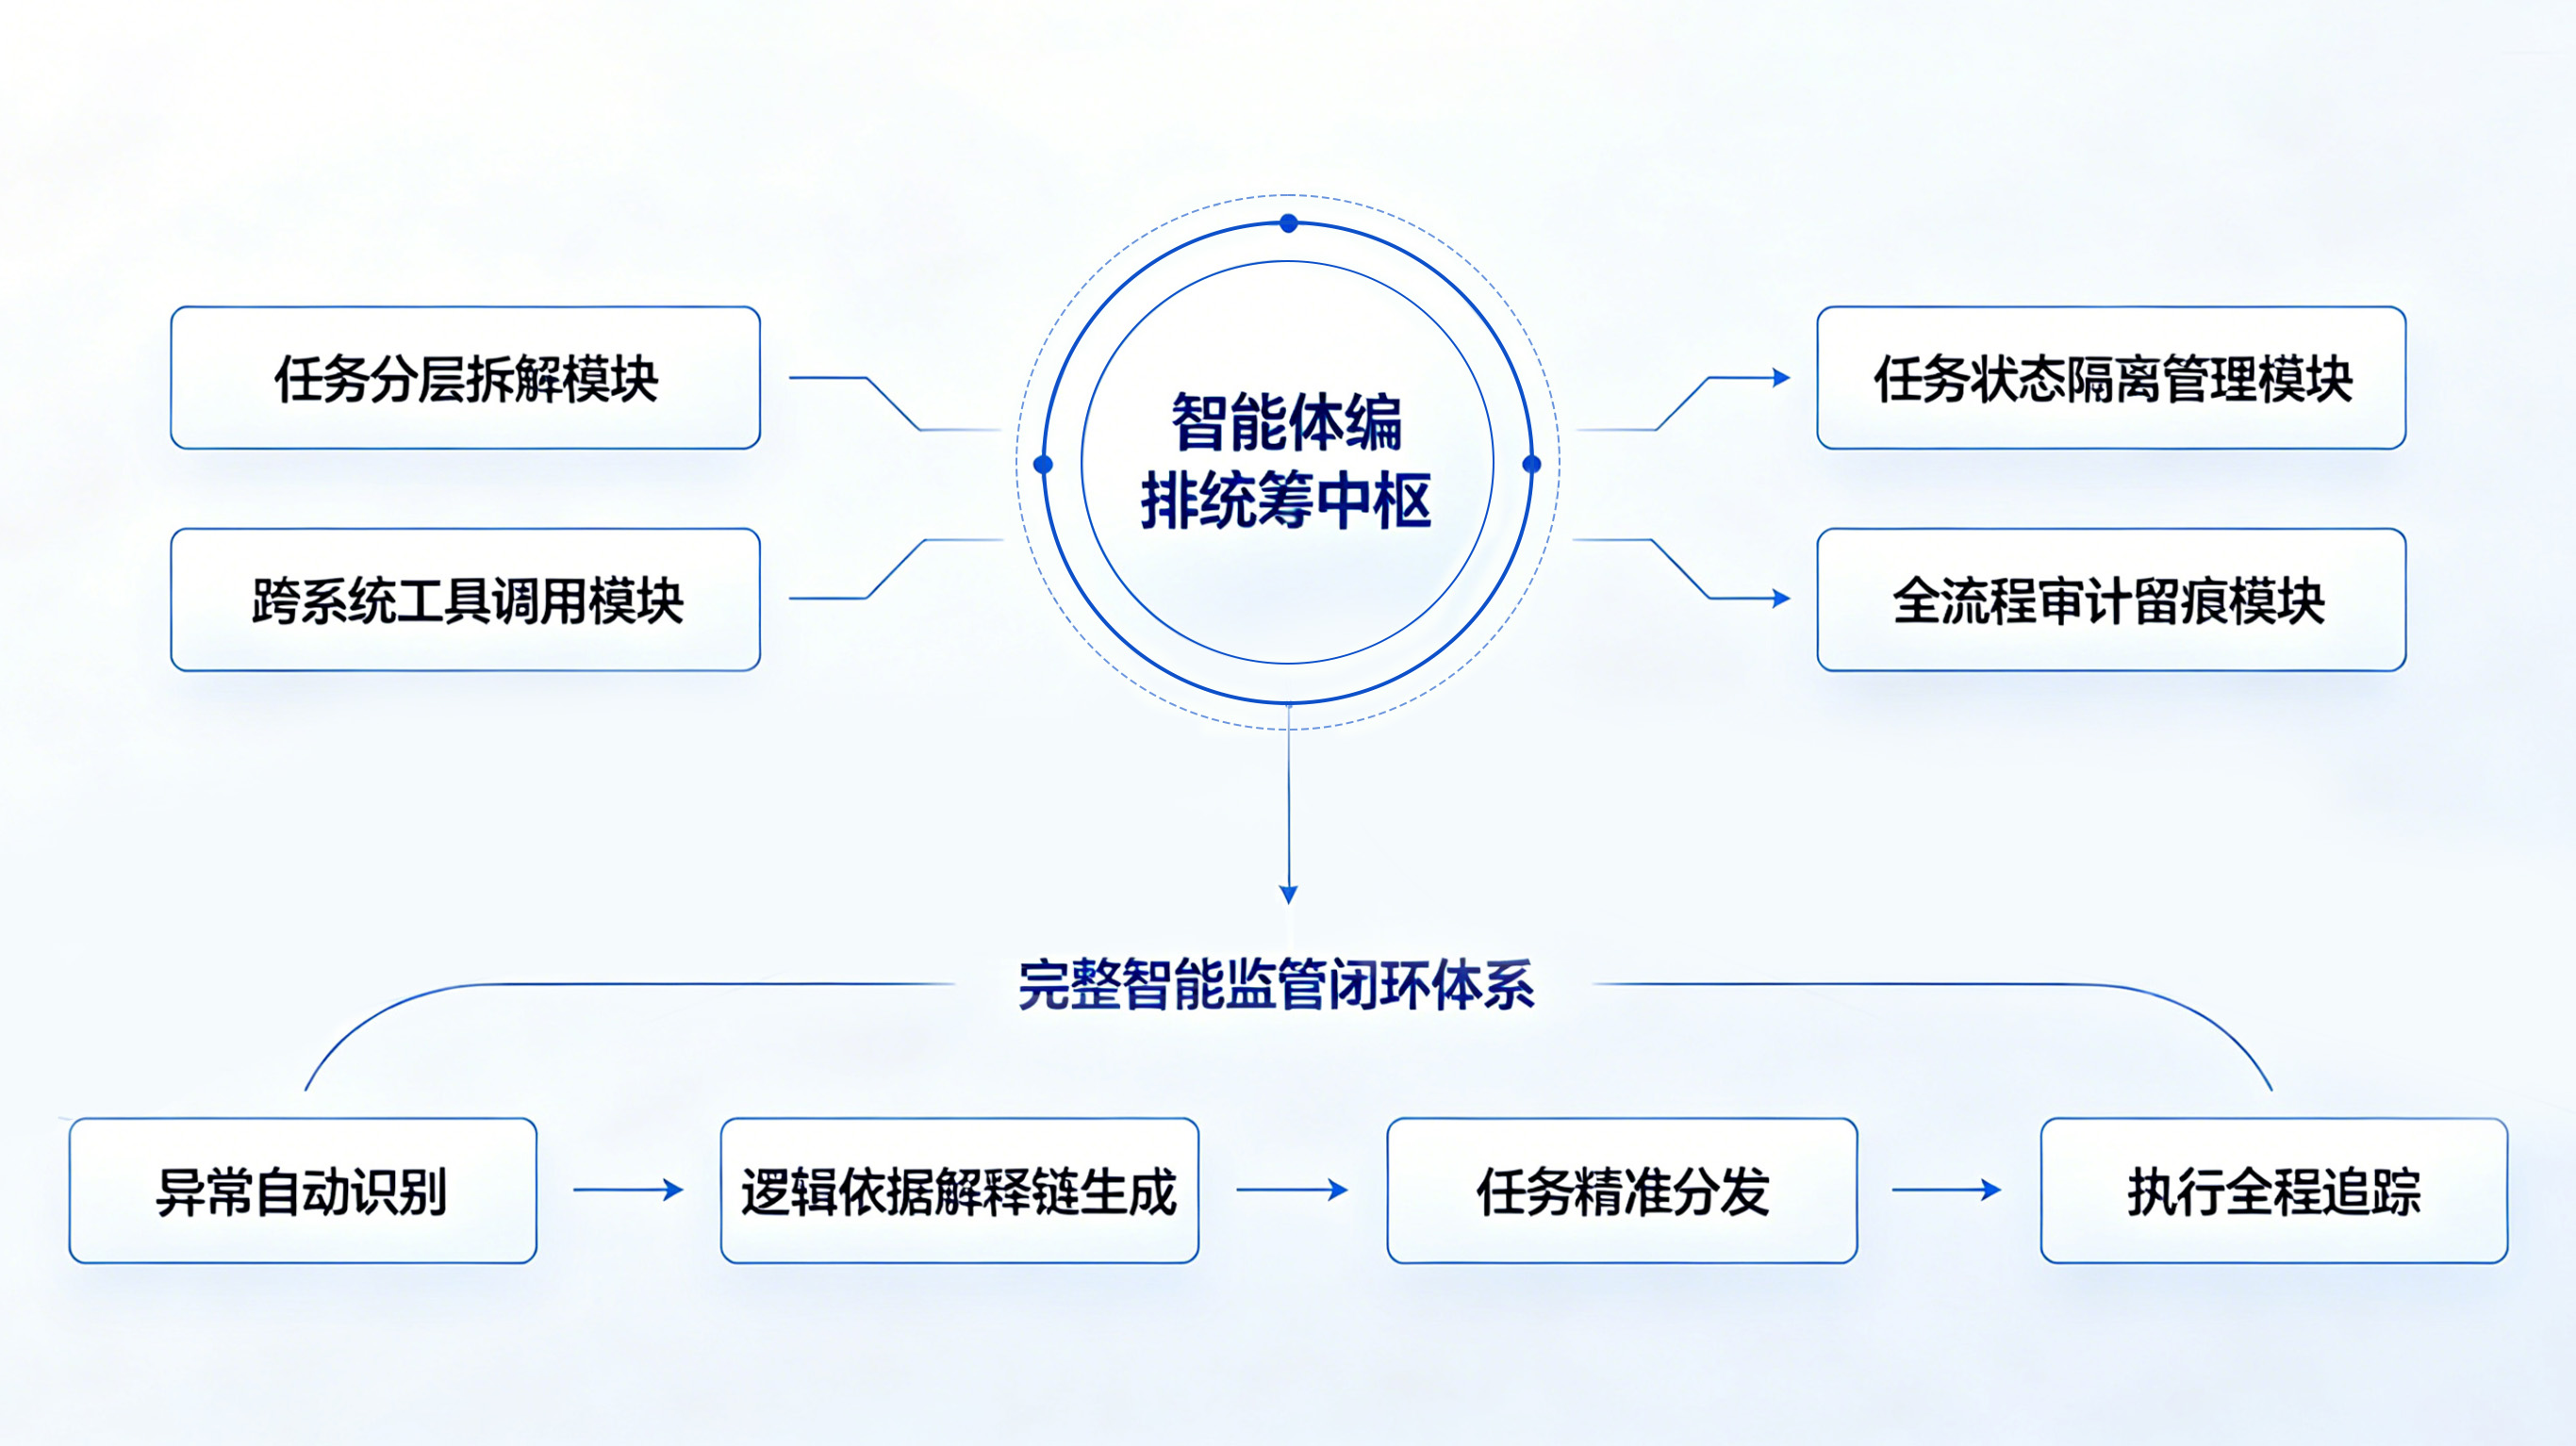
关键词:可闭环性。
八、结语:结构问题,不是模型问题
水务 AI 智能体的落地,没有捷径,但有方法。
不要等数据完美才开始,不要等顶层设计完成才动手,更不要指望一个大模型解决所有问题。 从高频痛点单点突破,用数据治理与语义层夯实底座,以智能体编排实现可控协作,以监管闭环确保落地有效,AI 才能真正从"概念热点"变成"运营刚需"。
一个容易被忽略但至关重要的结论:
企业 AI 不是"模型能力问题",而是"系统结构是否允许 AI 成为执行体"的问题。
如果没有数据治理结构、没有语义层、没有可编排的 Agent 体系,那么再强的大模型,也只能做"高级报表生成器"。
让数据活起来,让经验留下来,让决策快起来 — 这才是水务运营新周期里,AI 该有的样子。
文末互动
如果你的水务系统正在升级 AI 智能体,你认为最难突破的是什么?
A. 数据治理(标准不统一,多系统割裂)
B. 语义层构建(业务语言无法结构化)
C. 智能体编排(系统无法控制,不敢放权)
D. 组织协同(人不信 AI,不敢用)
欢迎在评论区留下你的答案
