


水务企业数据用不起来?问题可能出在"语义层"
全国污水处理能力接近饱和,新建项目锐减,运营资产盘活成为核心战略。SCADA/PLC系统积累的历史数据,正从"沉睡成本"转为"战略资产"。
但一个尴尬的现实是:很多水务企业"数据不少,用起来的不多"。多厂多系统各自为政,生产、财务、采购数据口径不一,传统工具只能做固定展示,无法跨系统关联分析。数据价值被锁死在各自的"烟囱"里,看得见,摸不着。
问题往往不是缺数据,而是缺一层"业务翻译"。
一、为什么数据"有"却"用不起来"?
想象这样一个场景:生产部门拉出一张"吨水成本"表,财务部门也拉出一张"吨水成本"表,两个数字对不上 — 因为生产按实际电耗计算,财务按预算分摊,经营系统又按处理量加权。三个部门各说各话,开会先花半小时对齐口径。
再比如,AI智能体读取底层数据库时,看到"COD"这个字段,它怎么知道这是"进水COD"还是"出水COD"?看到"风机温度",它怎么判断对应哪台设备、正常阈值是多少?
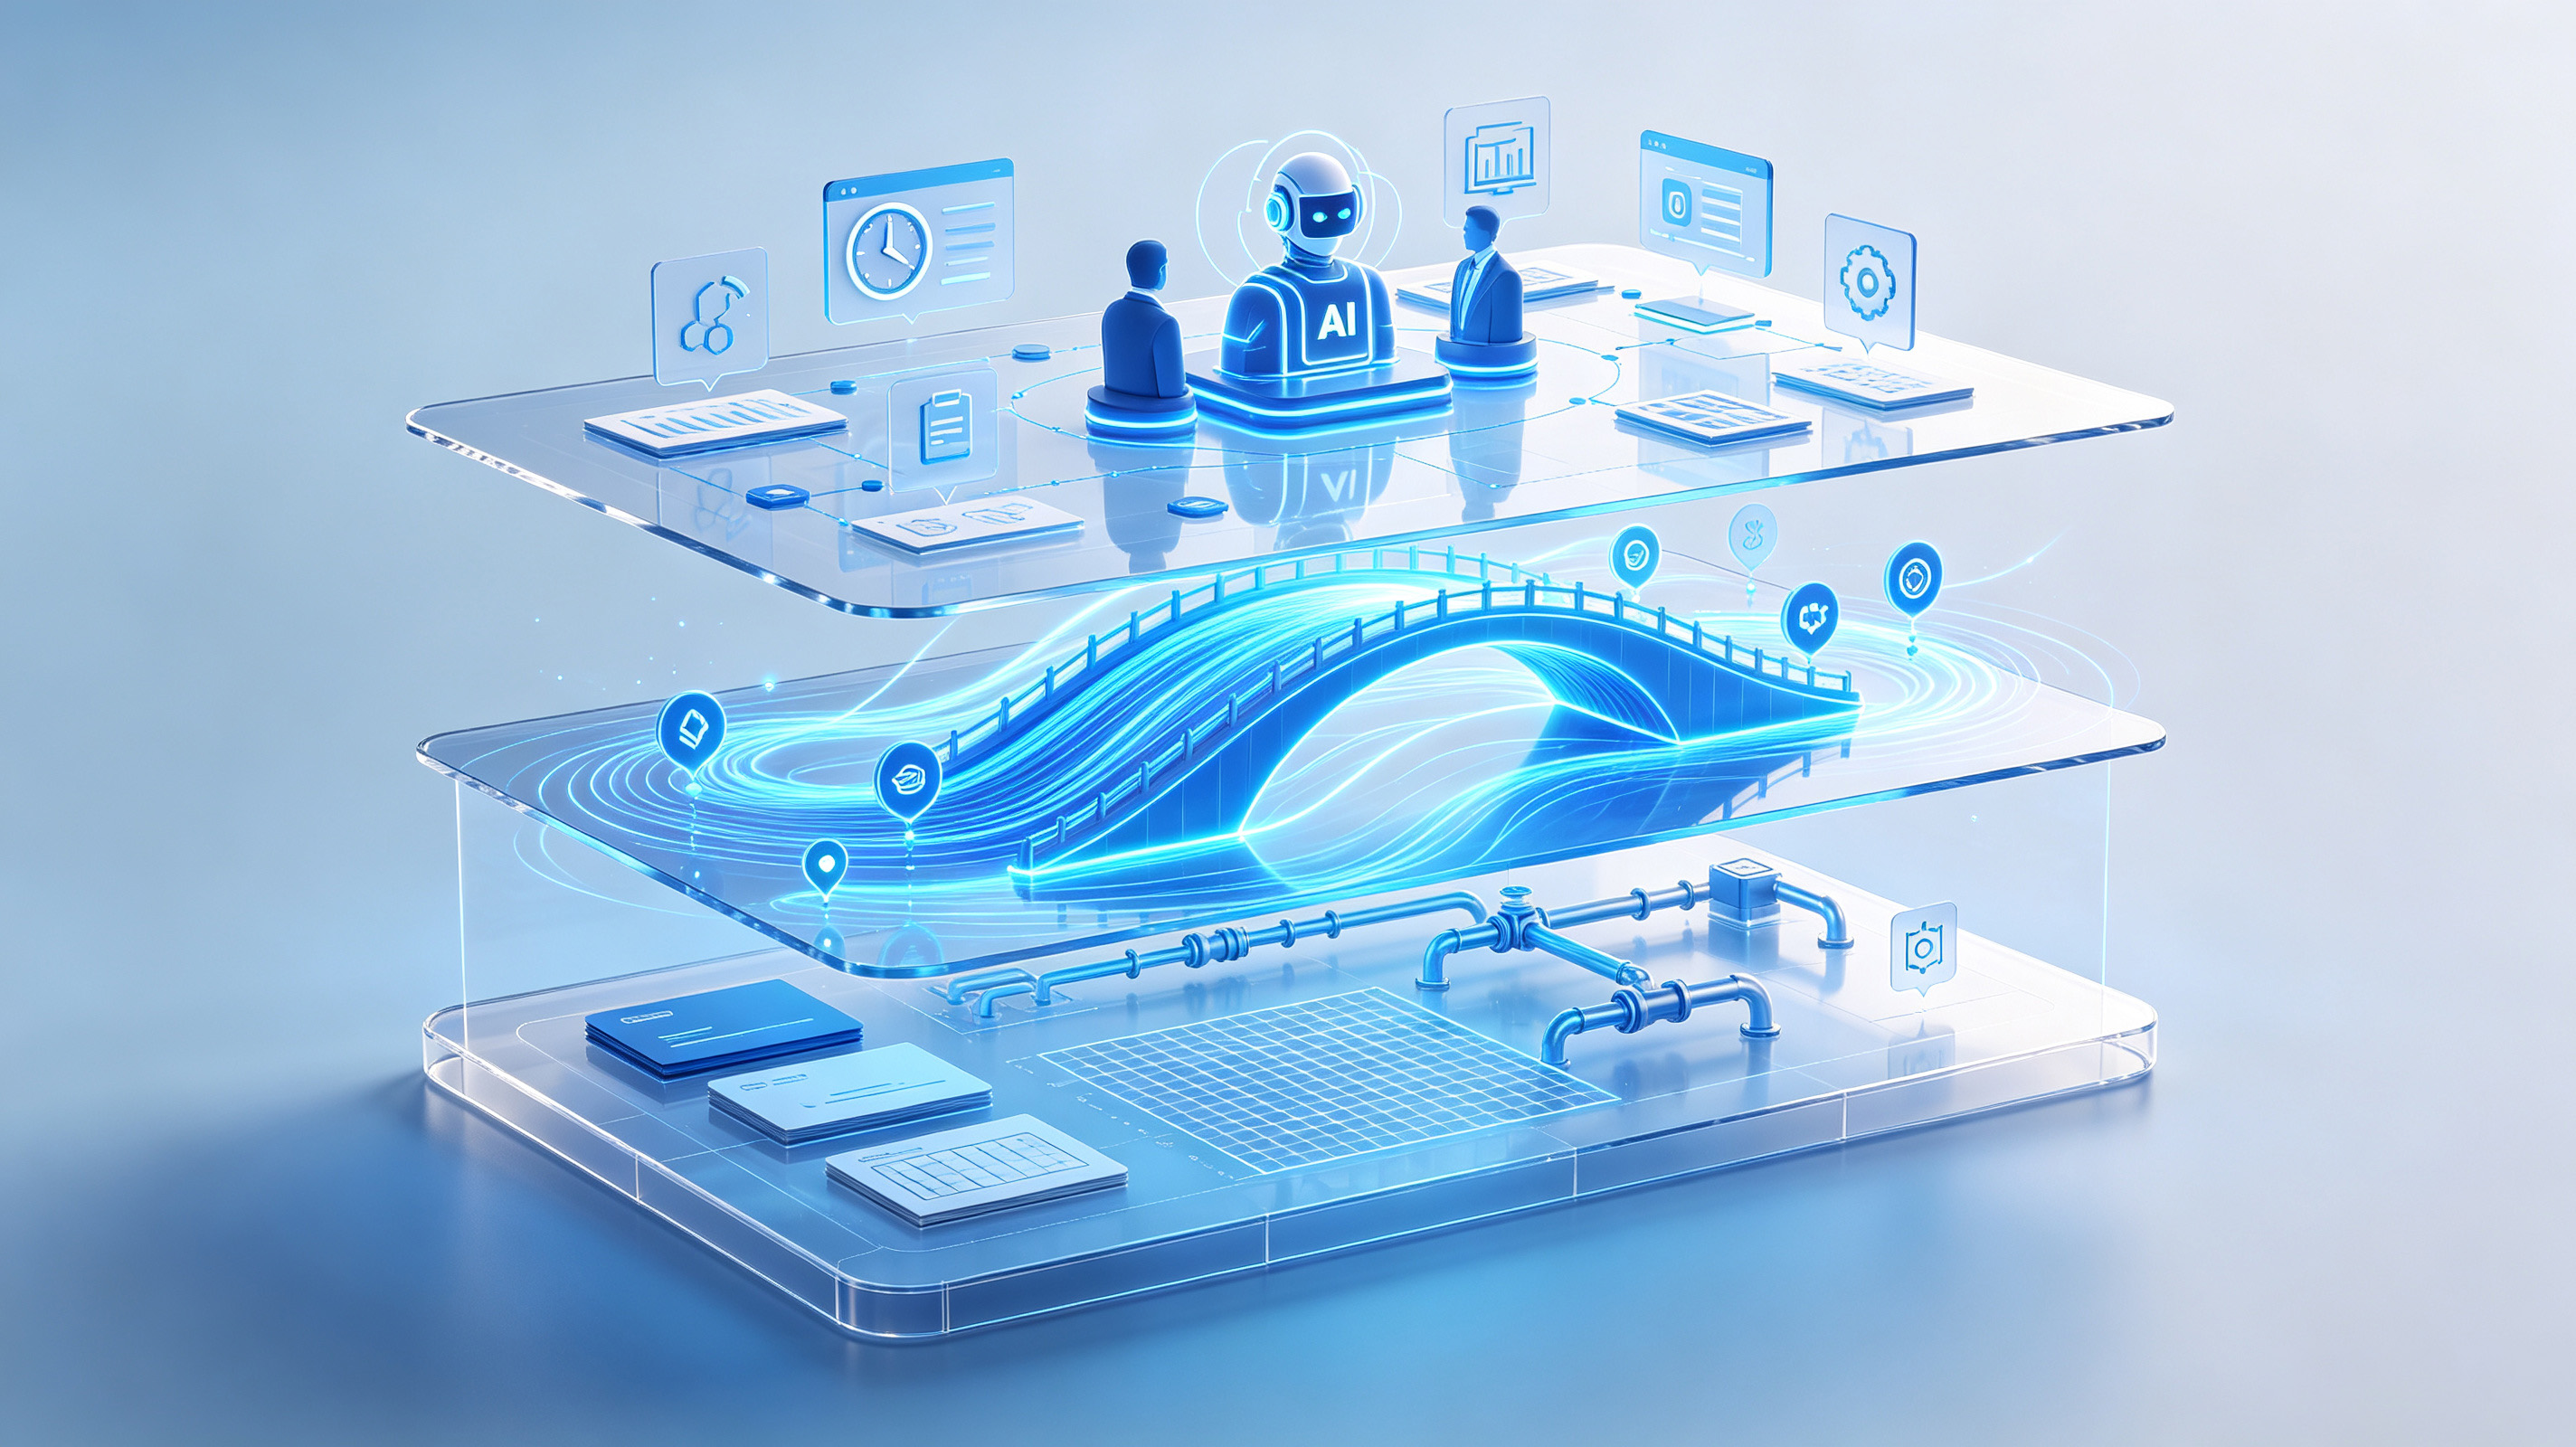
底层数据存储的是物理字段名和原始数值,而业务人员和AI需要的是"业务语言"。两者之间,缺少一座桥梁。这座桥梁,就是语义层。
二、语义层:给数据加一层"业务翻译"
语义层是位于原始数据和业务使用者之间的抽象层。它把数据库里的物理表名、字段名、计算逻辑,映射成业务人员日常使用的术语。
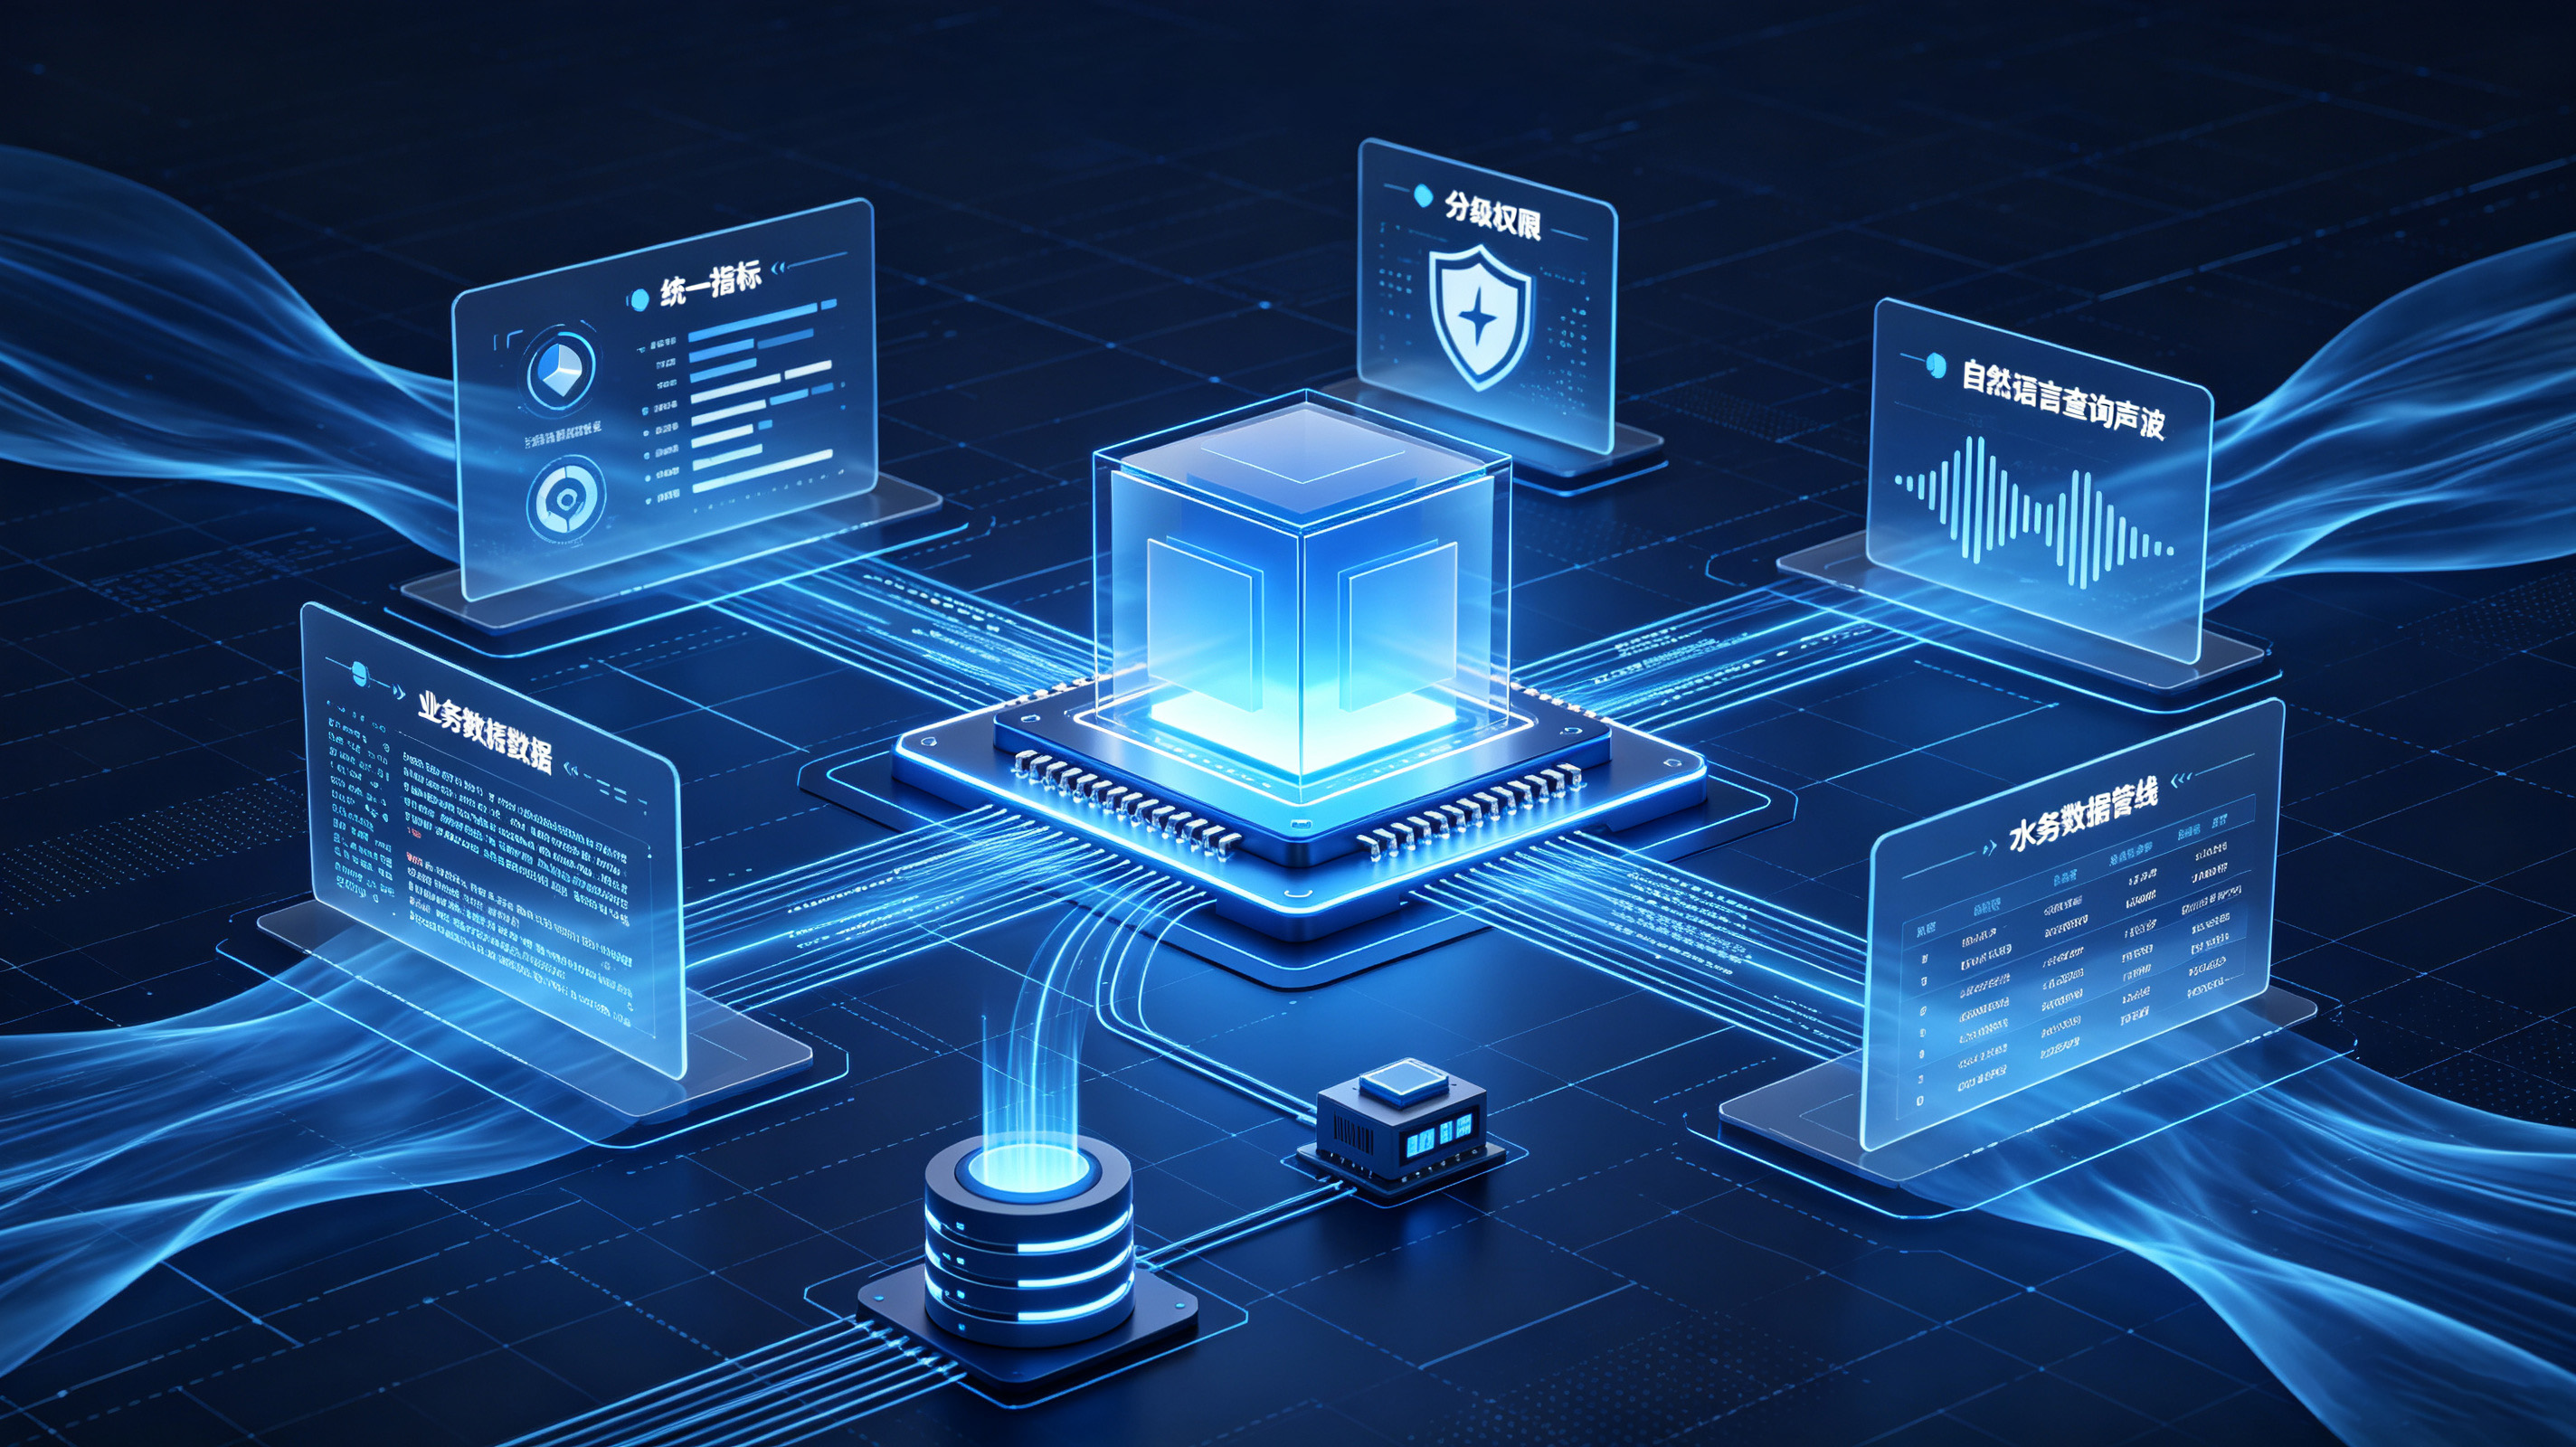
打个比方:底层数据是"方言",业务人员讲"普通话",语义层就是中间的"翻译官"。它承担三个核心职责:
指标一致性
"吨水成本""设备完好率""进出水达标率"这些指标,在全公司范围内只定义一次。无论哪个部门、哪个厂区查询,看到的都是同一个计算逻辑,彻底告别"各算各的"。
访问治理
厂长看全厂汇总,值班员看本岗实时数据,管理层看经营分析 — 不同角色自动匹配不同权限。敏感数据自动脱敏,规则一次配置,全平台生效。
查询抽象
业务人员不需要懂技术语言,也不需要知道数据存在哪里、怎么关联。只要用业务语言提问,比如"本月电耗异常的厂区有哪些",语义层自动完成底层计算,返回可直接使用的答案。
三、AI智能体为什么离不开语义层?
AI智能体能够理解意图、感知环境、调用工具、执行任务。但在水务场景中,如果AI直接读取原始数据库,它看到的只是冰冷的字段名和数字,缺乏业务上下文,很容易"答非所问"。
语义层给AI提供了一份"业务说明书":每个指标的含义、计算方式、适用场景、关联关系。AI基于语义层生成分析,才能真正"懂业务",而不是凭概率"猜答案"。
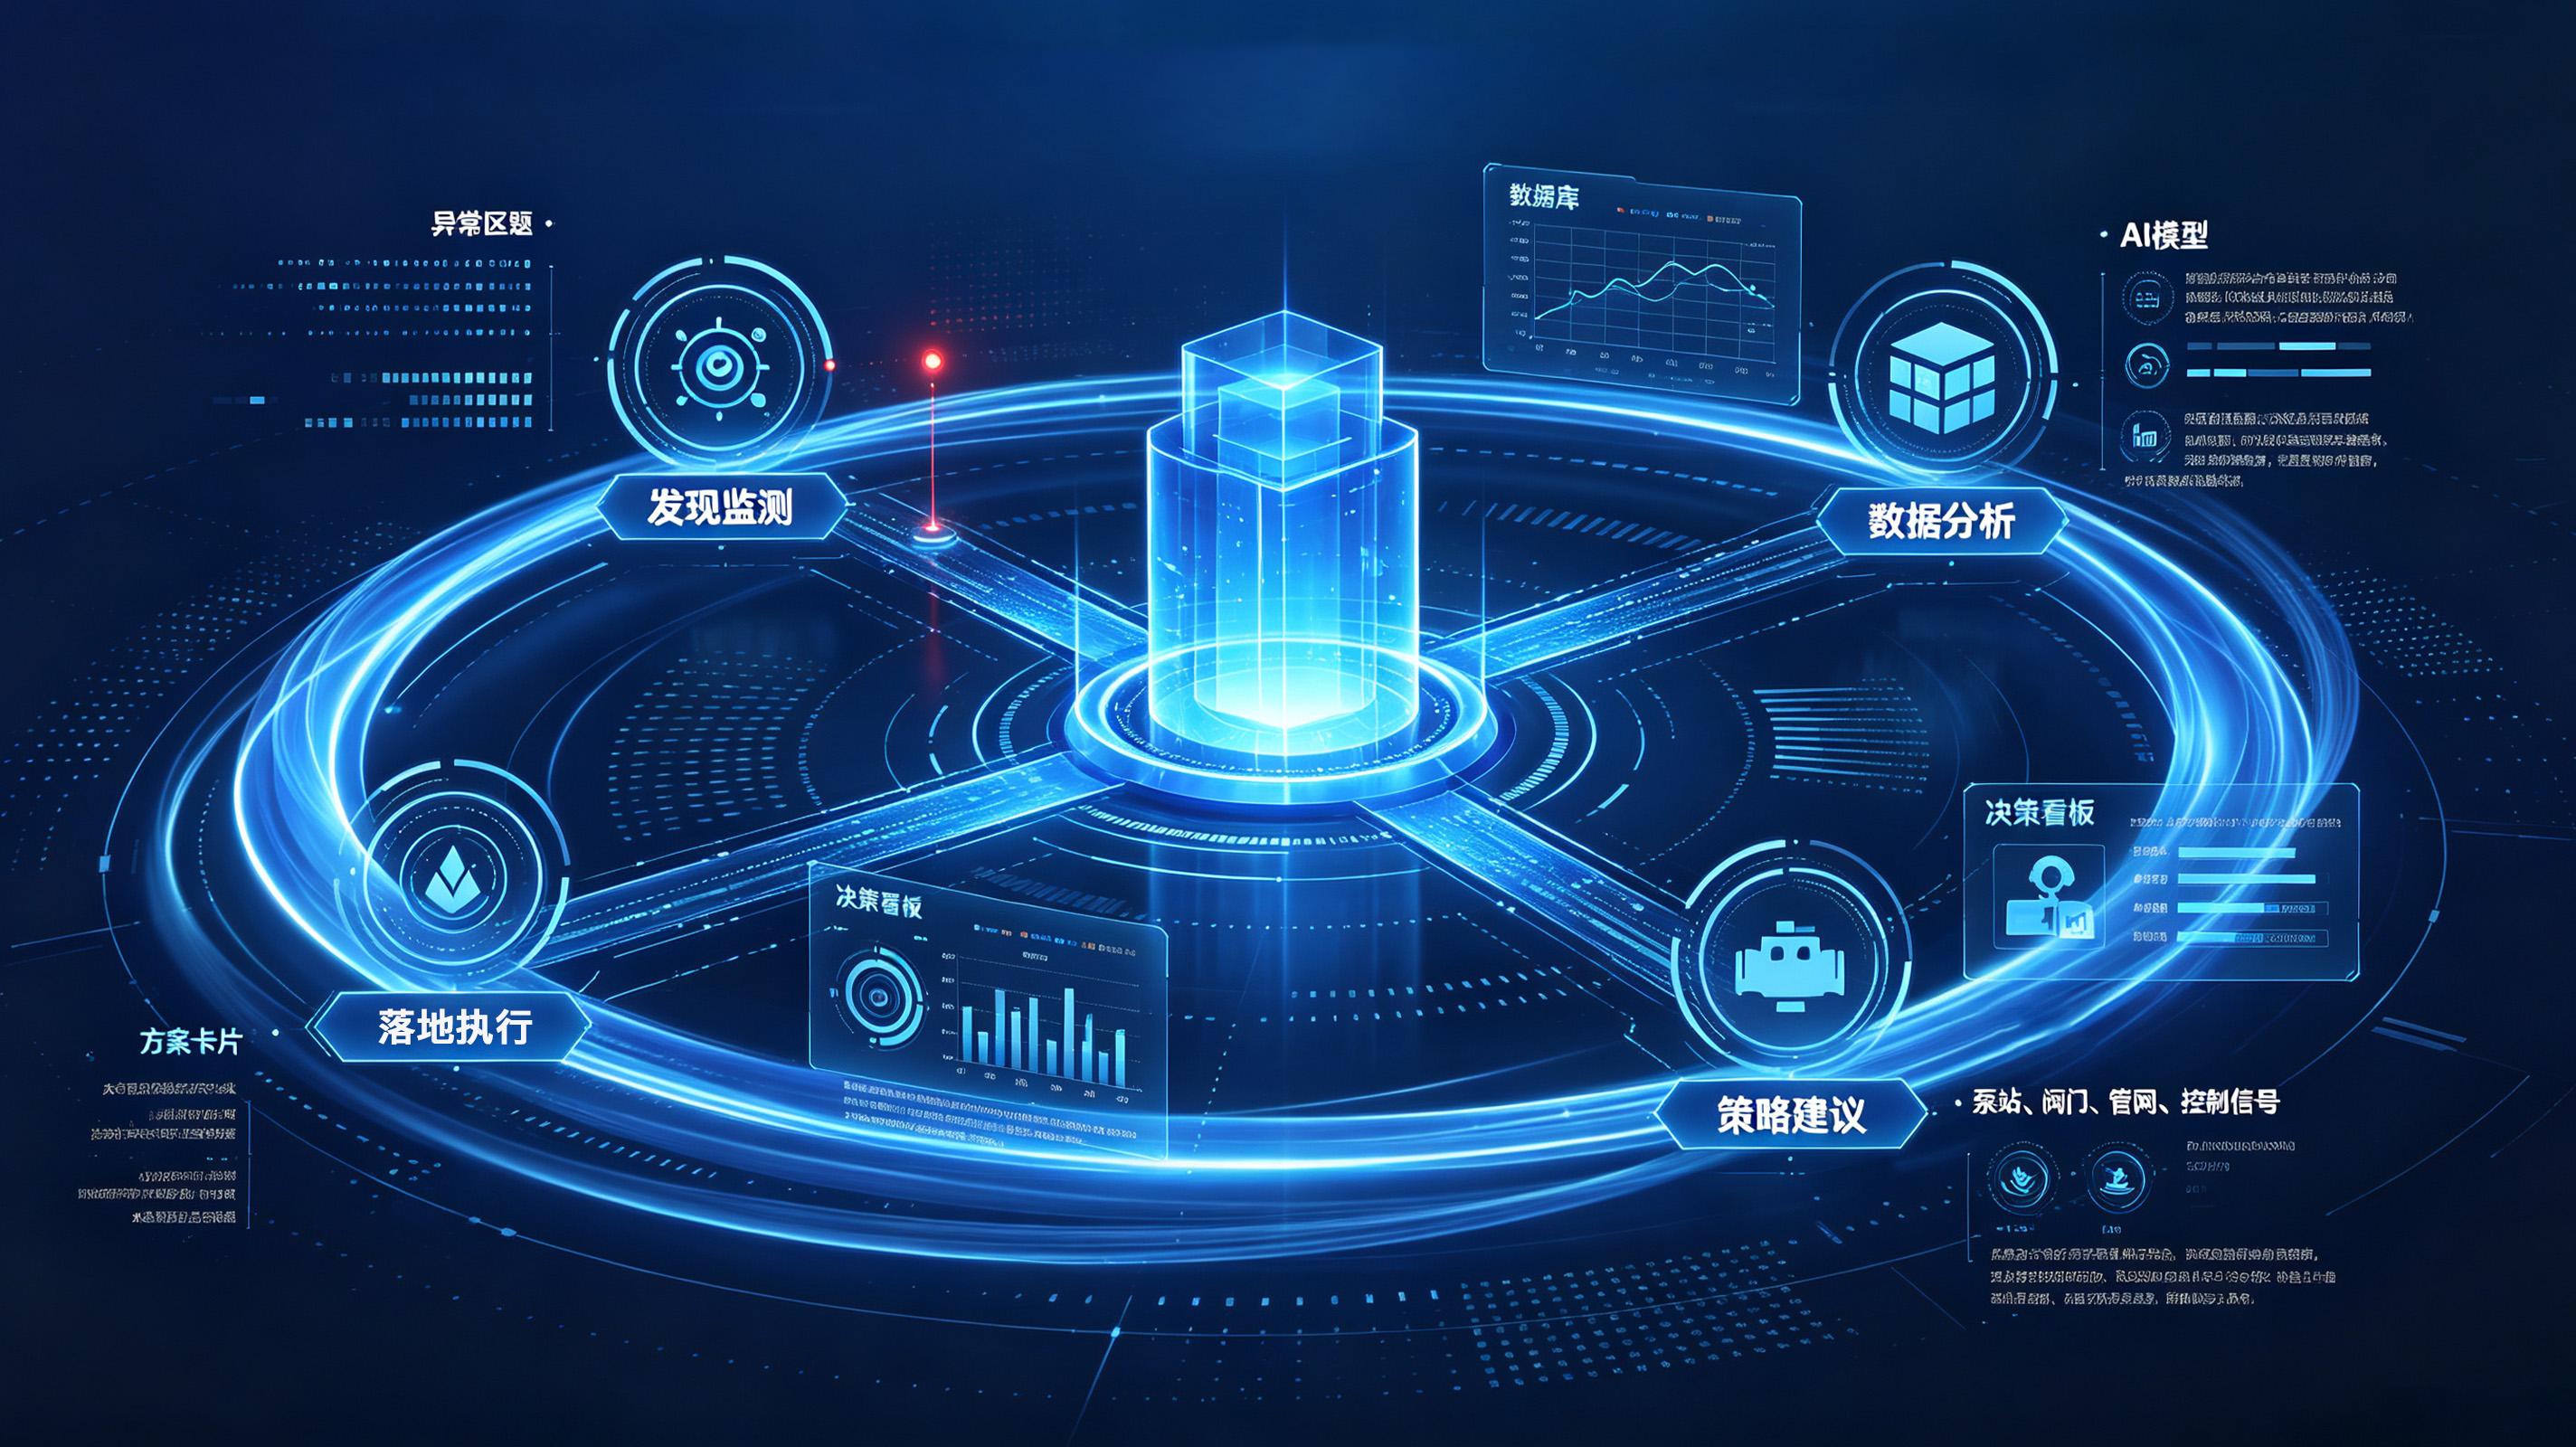
这与如昼科技"小模型做判断、大模型做表达"的技术路线高度契合 — 小模型在数据层做精准识别,判断异常趋势与偏离点位;大模型在语义层做业务翻译,把参数转化为可执行的决策建议。两者通过统一语义层协同工作,实现"发现—分析—建议—执行"的闭环。
没有语义层,AI智能体就像一位外语流利却不懂专业术语的翻译,词都认识,意思却可能南辕北辙。
四、水务企业如何构建语义层?
语义层不是一次性工程,而是一个持续迭代的系统。建议从以下步骤入手:
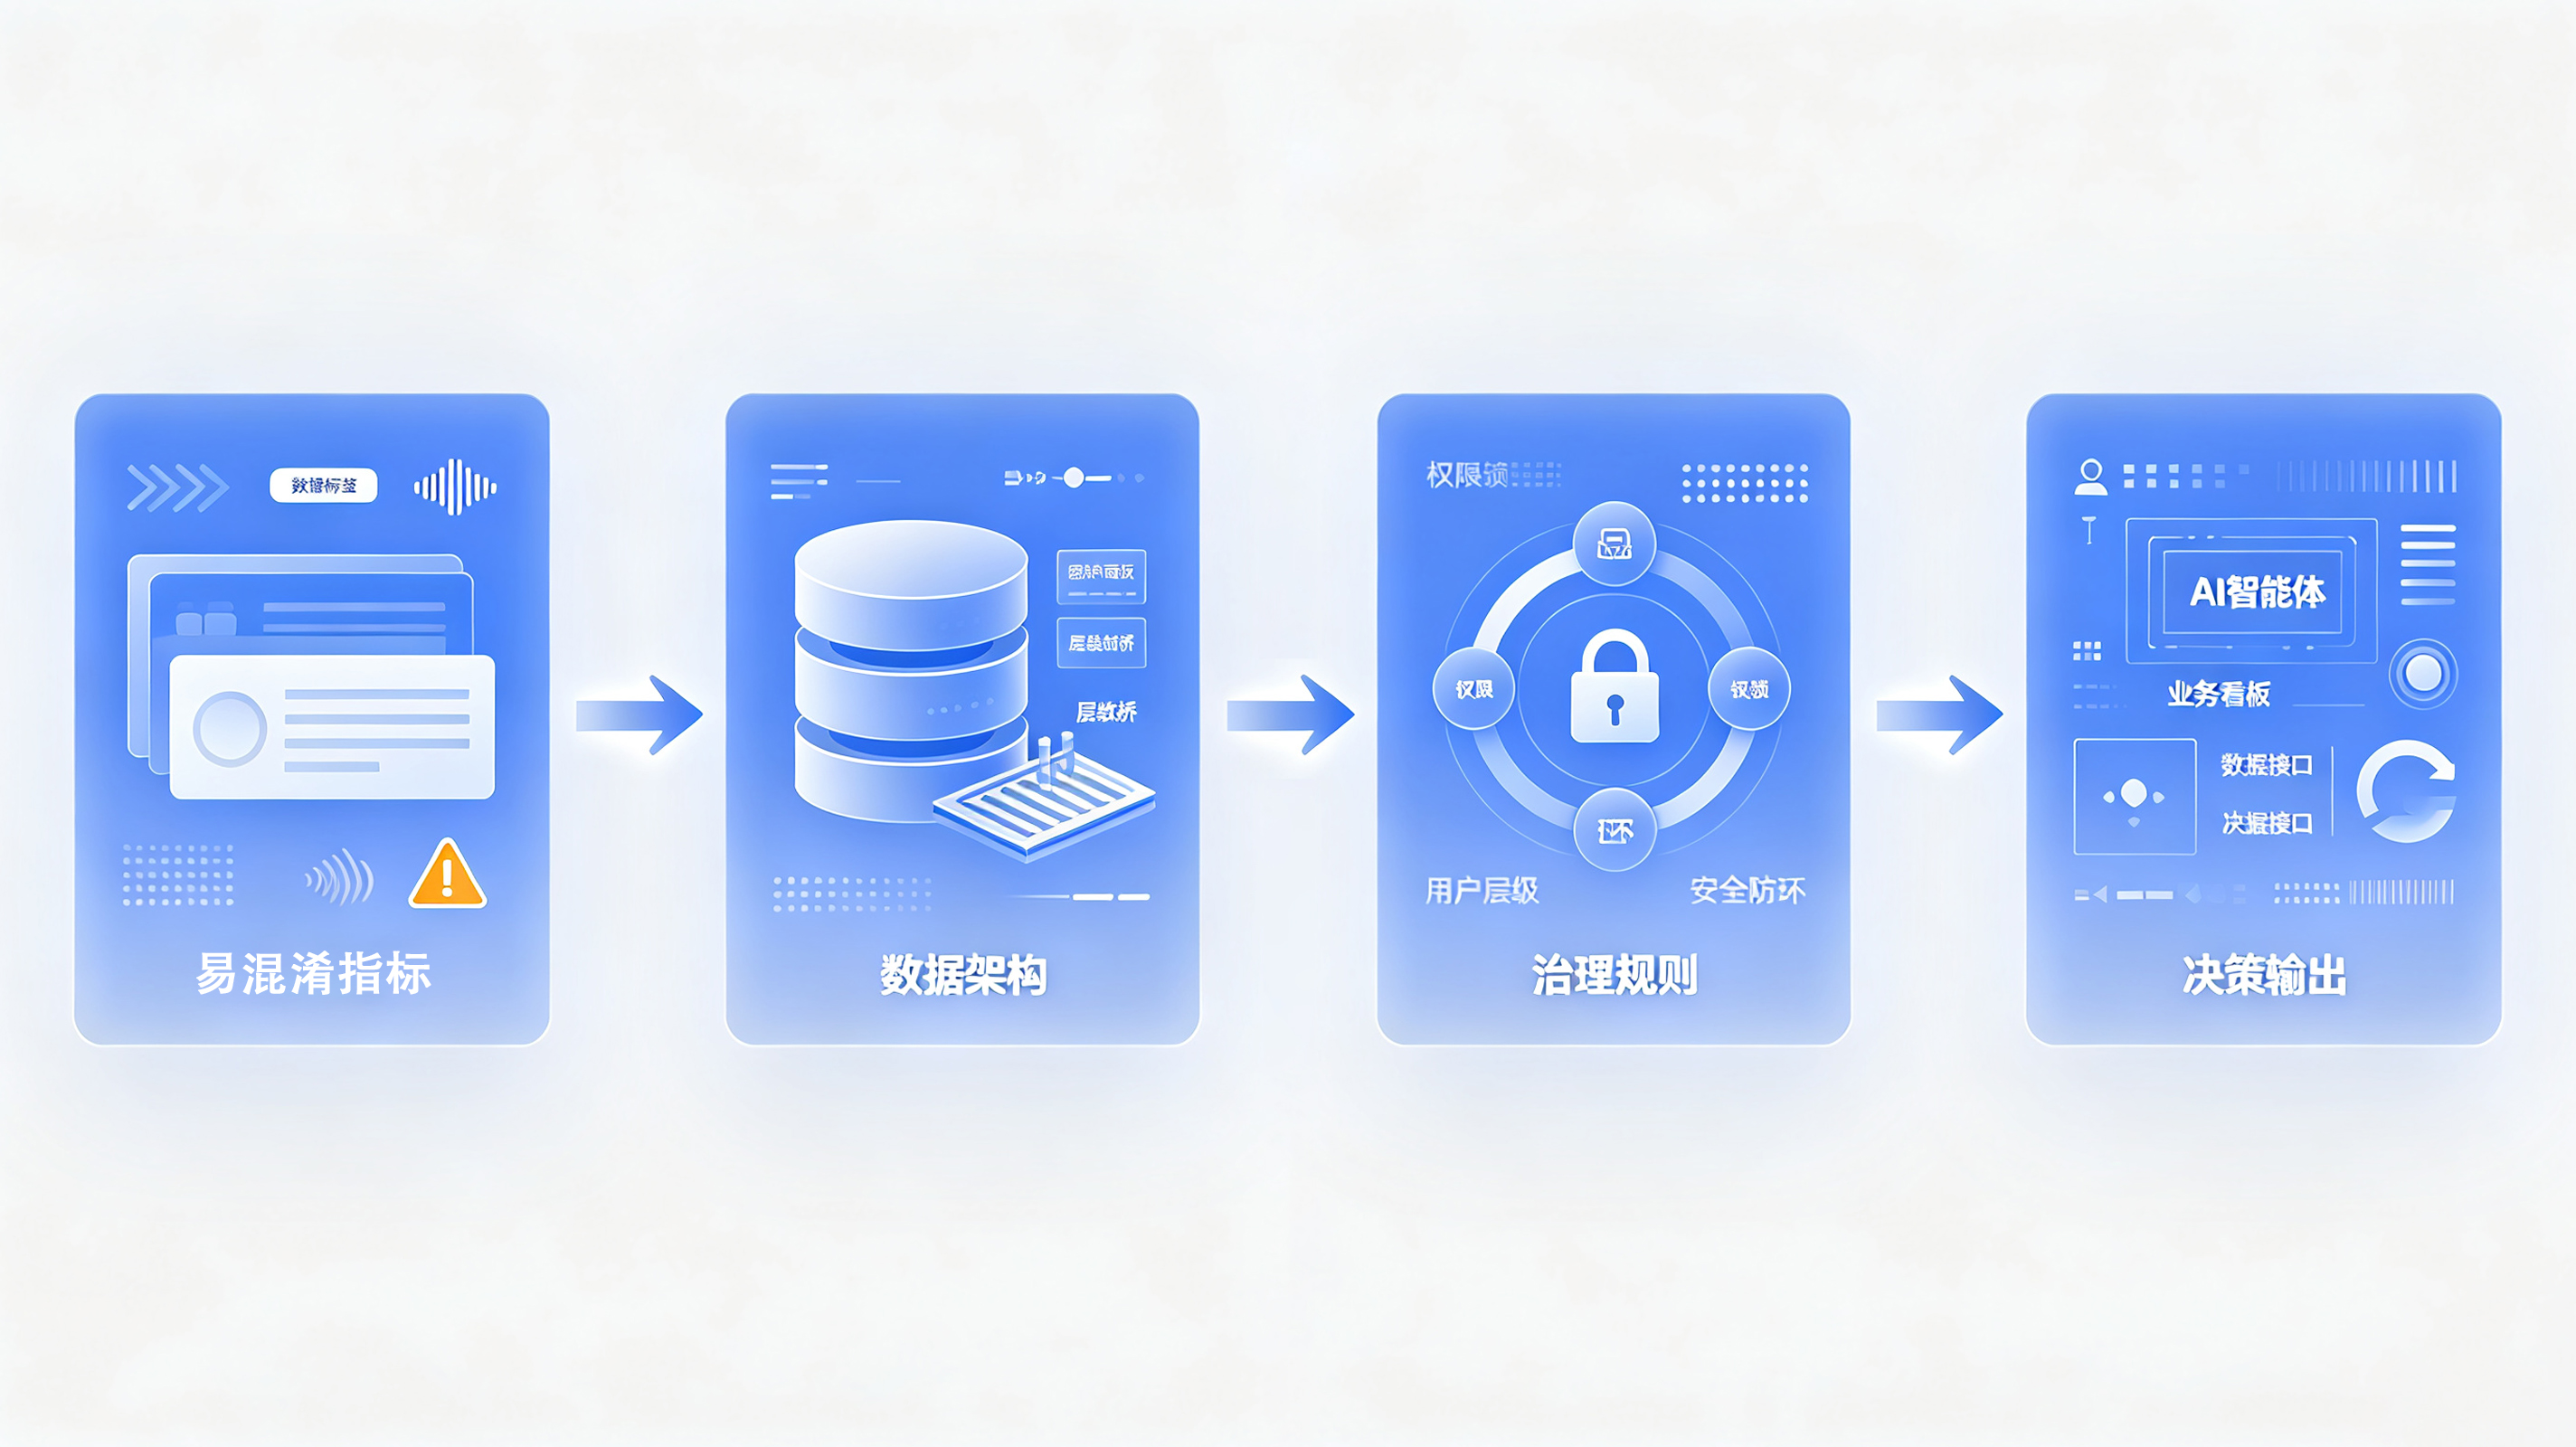
第一步:锁定"最容易打架"的指标
先从全公司使用频率最高、口径最容易混淆的指标入手,比如吨水成本、设备完好率、进出水达标率。把这些指标的定义、计算逻辑、数据来源统一固化。
第二步:搭建分层视图
建立三层数据架构:原始数据层负责对接各系统数据源;业务逻辑层封装计算规则,把原始字段翻译成业务指标;应用层面向不同场景(经营分析、生产调度、环保合规)输出定制数据集。
第三步:配套治理规则
明确谁可以看什么数据、看到什么粒度。权限控制到厂区、岗位,敏感参数自动脱敏。规则配置一次,对所有查询方式(包括AI提问)统一生效。
第四步:接入AI智能体
当语义层完备后,业务人员可以用自然语言向AI提问,AI基于语义层自动生成准确的分析,并调用工具完成派单、预警、通知等操作。数据从"看得见的报表"变成"用得上的生产力"。
五、结语
水务行业正从"工程驱动"走向"运营驱动",从"靠经验"走向"靠数据"。但数据本身不会说话,需要语义层把它翻译成业务语言,再让AI智能体把它变成运营动作。
如昼科技在数据资产中台建设中,将统一数据标准、建立跨部门统一语义层作为核心底座,正是为了让水务企业的数据资产真正流动起来,让AI智能体真正理解水务业务。
存量时代,比"收集数据"更重要的,是"统一语言";比"上系统"更重要的,是"让系统听得懂人话"。这,或许是水务数字化从"面子"走向"里子"的关键一步。
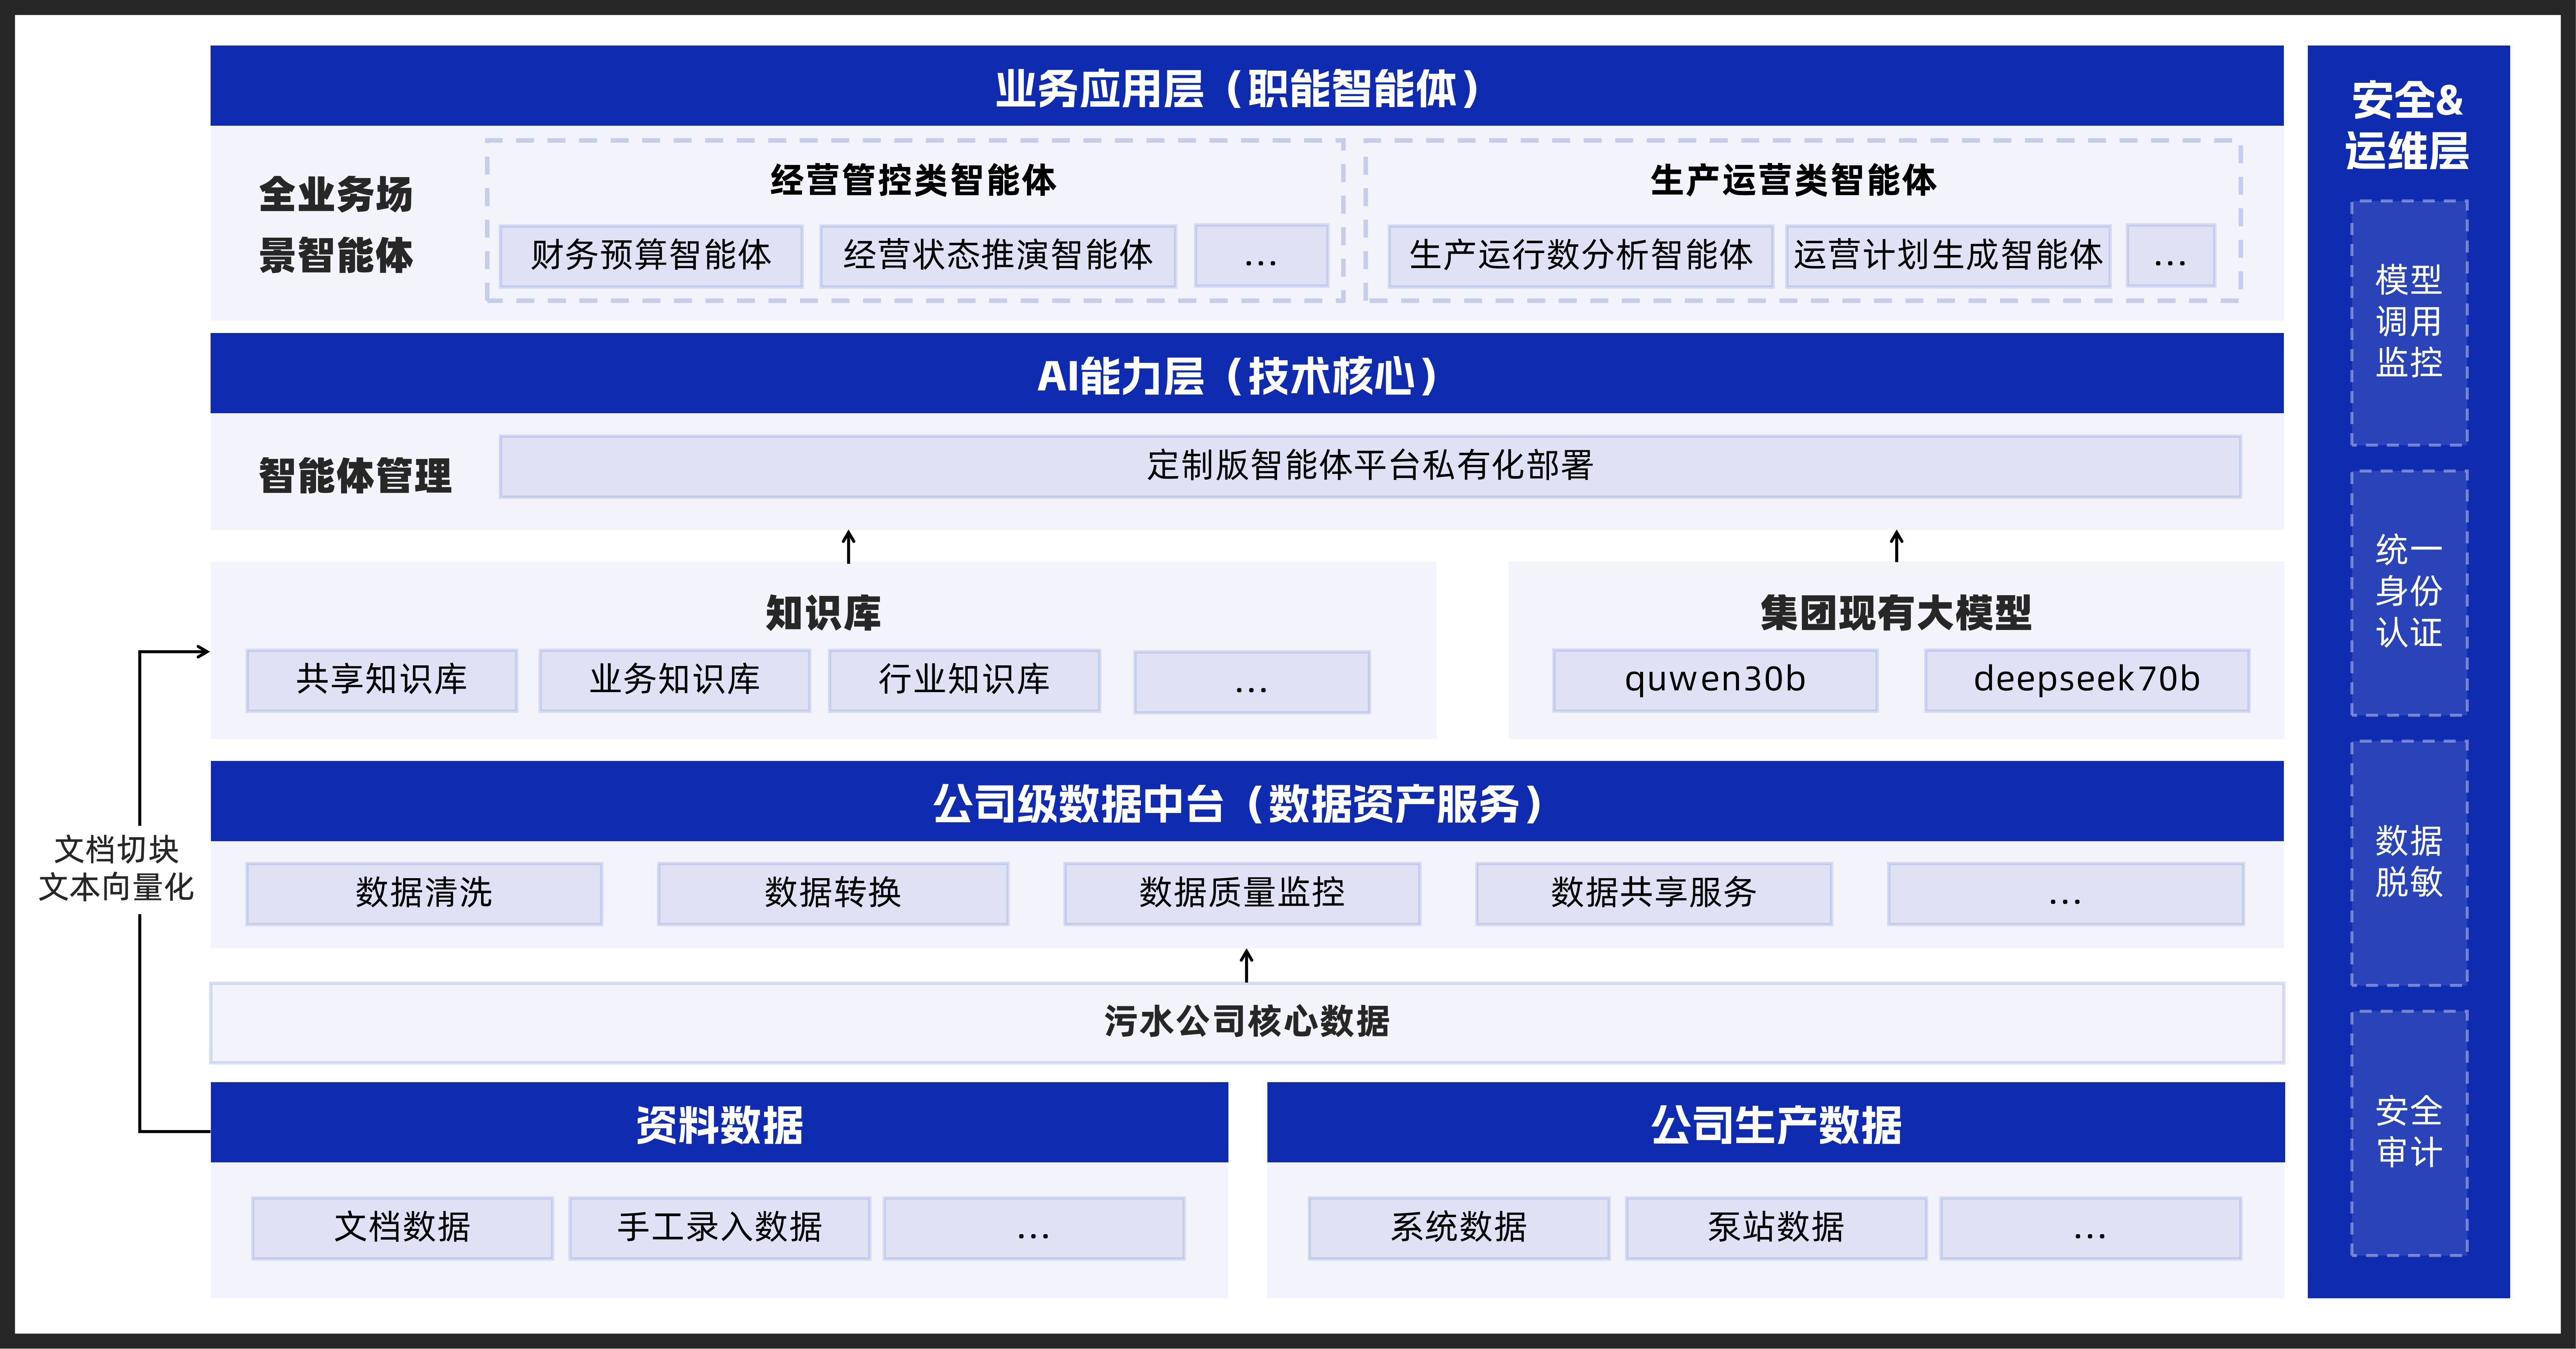
技术架构:"五层双擎"AI技术体系
如昼科技 | 让水务企业运营安全、高效、具有质价比
